视频:Flow-based Generative Model
细水长flow之NICE:流模型的基本概念与实现
Introduction
主流的生成模型可分为三类,component-by-component(autoregressive)、AutoEncoder 和 GAN,但是这些模型都有着或多或少的问题:
-
component-by-component 指 逐个元素地生成,对于图片来说,生成顺序不一定是最佳的,而且逐元素的生成是很慢的; Slow generation;
-
VAE要优化的目标ELBO和实际需要优化的目标 对数似然 之间存在距离; Optimizing a lower bound
-
GAN一方面训练不稳定,另一方面因为不是component-by-component,所以在语音生成上不如 autoregressive
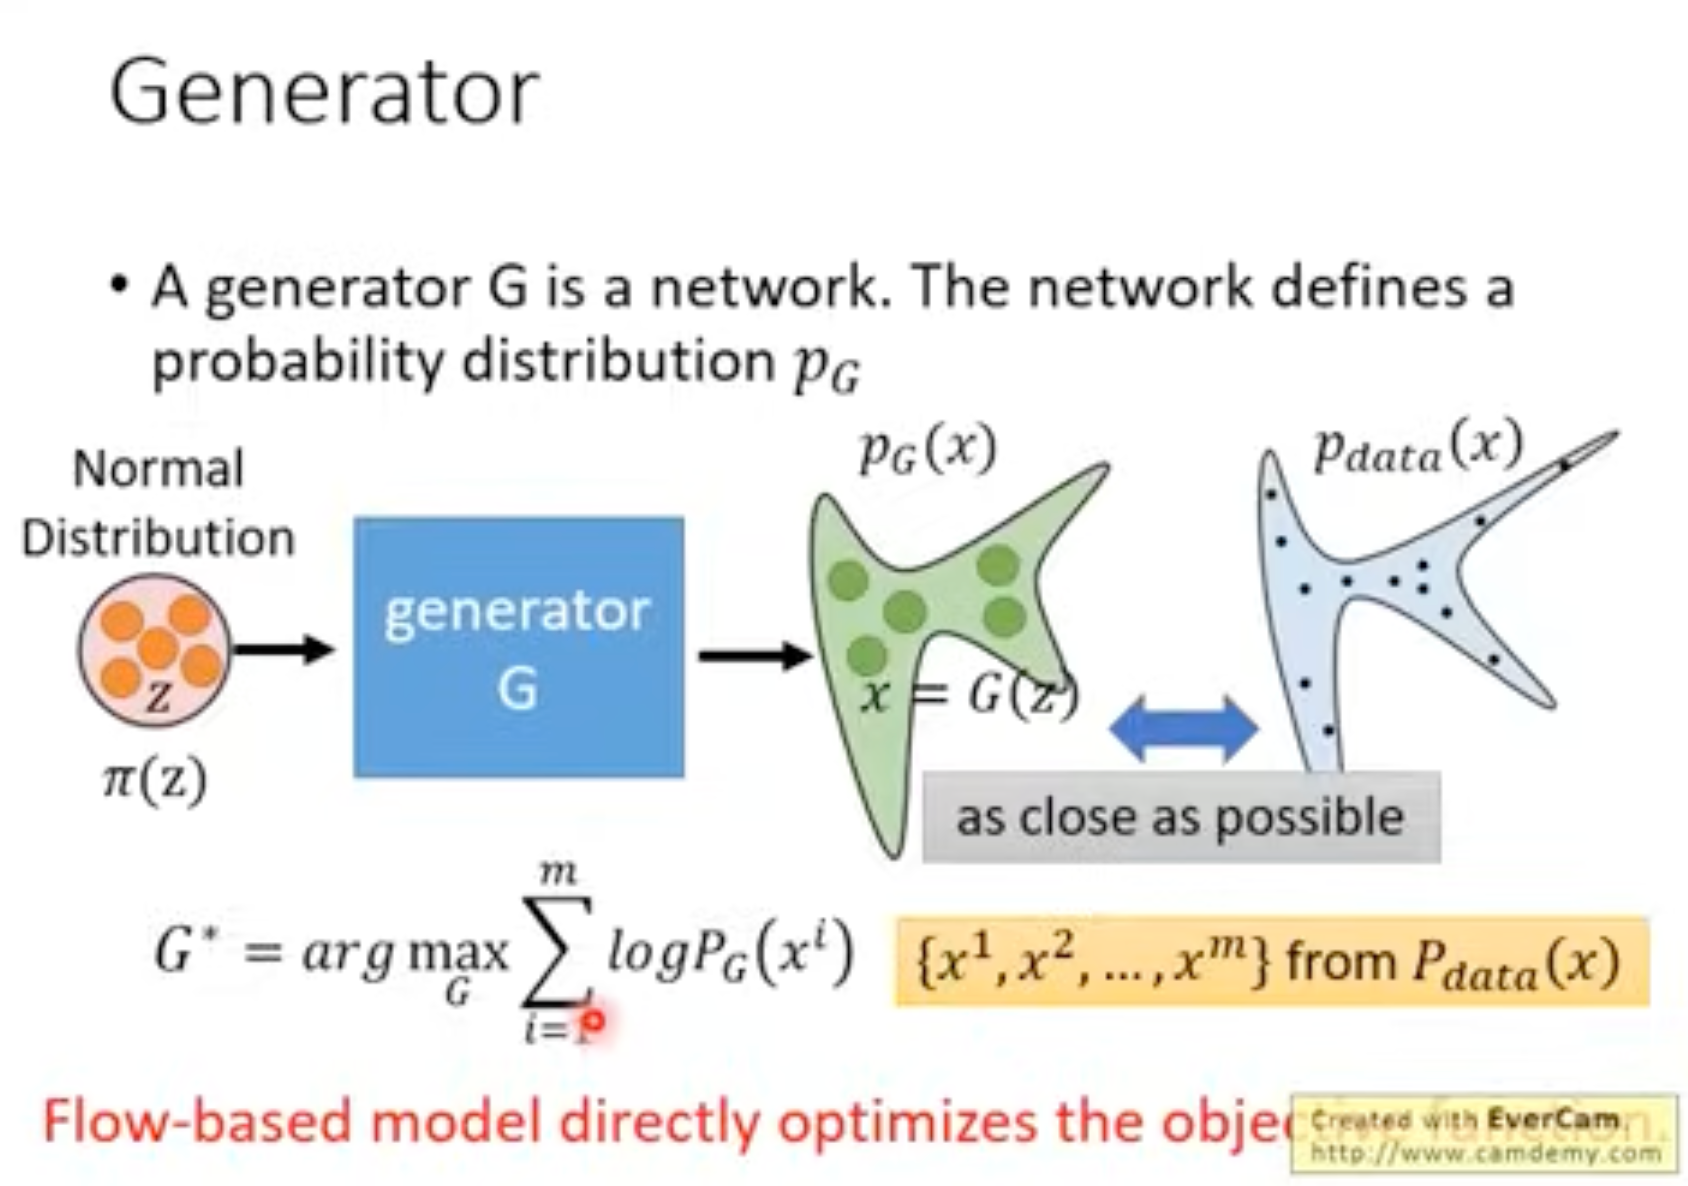
Flow-based model可以解决上述问题 (效果上不如GAN),对于从Normalized Distribution π(z) 生成复杂的目标分布 pG(x) 而言,需要优化的目标可以表示为 最大化 pG 采样的对数似然:
G∗=argGmaxi=1∑mpG(xi)≈argGmini∑mDKL(pdata∥pG)
其中, {x1,x2,...,xi} from pdata(x), pG(xi) 是真实图片在生成分布 pG 上的似然 likelihood (KL Divergence),第二行即VAE优化的目标ELBO,而Flow-based model可以直接优化第一行。
使得PG 和 Pdata 越像越好
Flow based model directly optimizes the object function
Jacobian Matrix
假设 z 和 x 直接满足以下关系:
x=f(z),z=[z1z2],x=[x1x2]
那么 z 与 x 之间的导数可以写作一个偏微分矩阵,如下所示:
Jf=[∂z1∂x1∂z1∂x2∂z2∂x1∂z2∂x2]input z∣output x
该矩阵被称为 Jacobian Matrix(雅各比矩阵)。
性质:假如存在反函数 z=f−1(x),则 Jacobian Matrix 可以表示为:
Jf−1=[∂x1∂z1∂x1∂z2∂x2∂z1∂x2∂z2]
且 两个逆过程的 Jacobian Matrix 相乘后等于单位矩阵:
Jf−1⊗Jf=I
这说明,互为反函数的两个函数,对应的 Jacobian Matrix 互为逆矩阵。
Determinant(秩)
从几何意义上讲,秩代表了由矩阵的行向量所组成的图形的面积/体积/...,因此是非负数。
而且对于任意一个矩阵 A,如果存在逆矩阵 A−1,则有:
det(A)=det(A−1)1
应用到反函数的 Jacobian Matrix,可以得到:
det(Jf−1)=det(Jf)1
Change of Variable Theorem
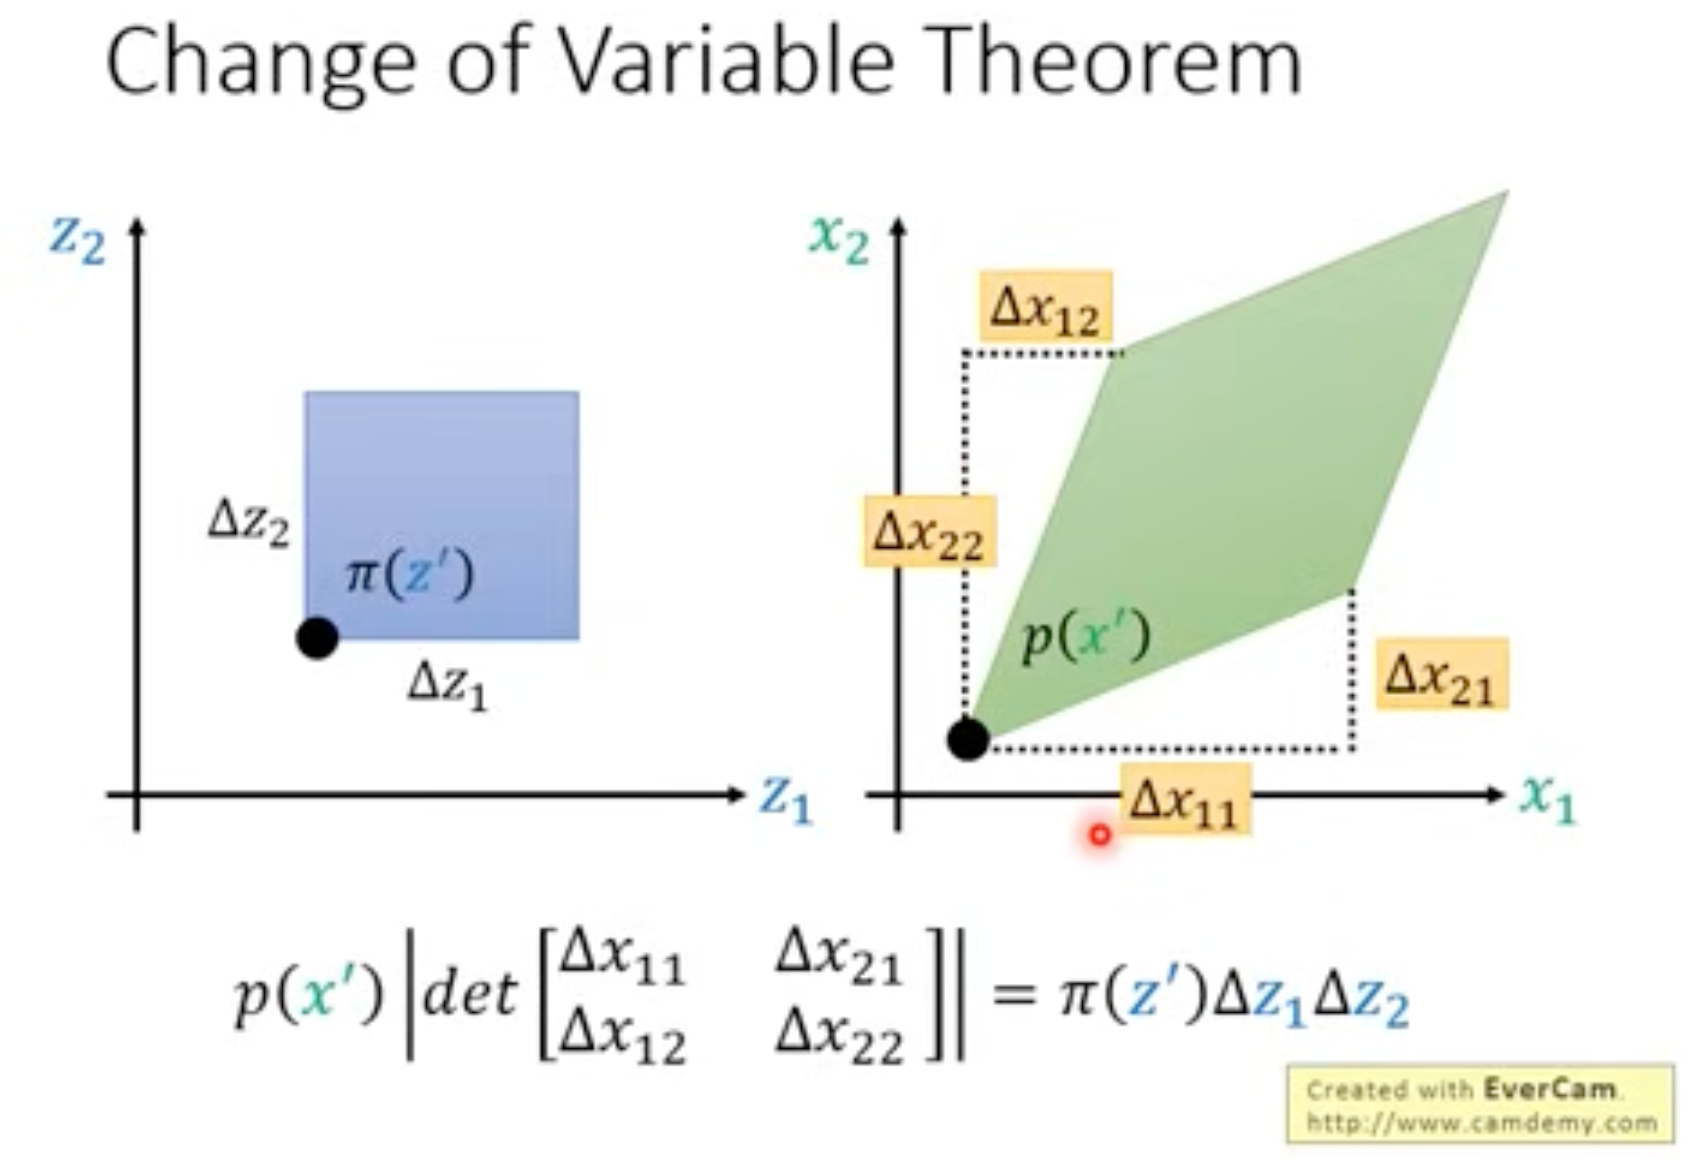
该定理描述了当 x=f(z) 时,p(x) 和 p(z) 满足以下关系:
p(x)⋅∣det(Jf)∣=π(z)
p(x)=π(z)⋅∣det(Jf−1)∣
要加绝对值,x 和 z 变化方向不确定
为了方便理解,下面以二维的情形进行证明:
证明
如上图所示,在 z 平面上随机选择一点 z′ 及其周边极小的正方形区域,经过 f(⋅) 之后投影到 x 平面上一点 x′ 及其周边的菱形区域,两个区域的概率应该相等,即:
π(z′)=Δz1Δz2p(x′)⋅det[Δx11Δx21Δx12Δx22]
矩阵转置后秩不变,因此可以写为:
π(z′)=Δz1Δz2p(x′)⋅det[Δx11Δx12Δx21Δx22]
进一步简化,表示为:
π(z′)=p(x′)⋅det[Δz1Δx11Δz2Δx12Δz1Δx21Δz2Δx22]
π(z′)=p(x′)⋅det[∂z1∂x11∂z2∂x12∂z1∂x21∂z2∂x22]
因此:
π(z′)=p(x′)⋅∣det(Jf)∣
结论
从图中不难看出,Δx12 表示因为 Δz2 导致的 Δx1 的变化,所以:
Δz2Δx12=∂z2∂x1
又因为 det(Jf−1)=1/det(Jf),所以:
p(x)=π(z)⋅∣det(Jf−1)∣
Coupling Layer
根据 Change of Variable Theorem 可以得到:
pG(xi)=π(zi)⋅∣det(JG−1)∣,zi=G−1(xi)
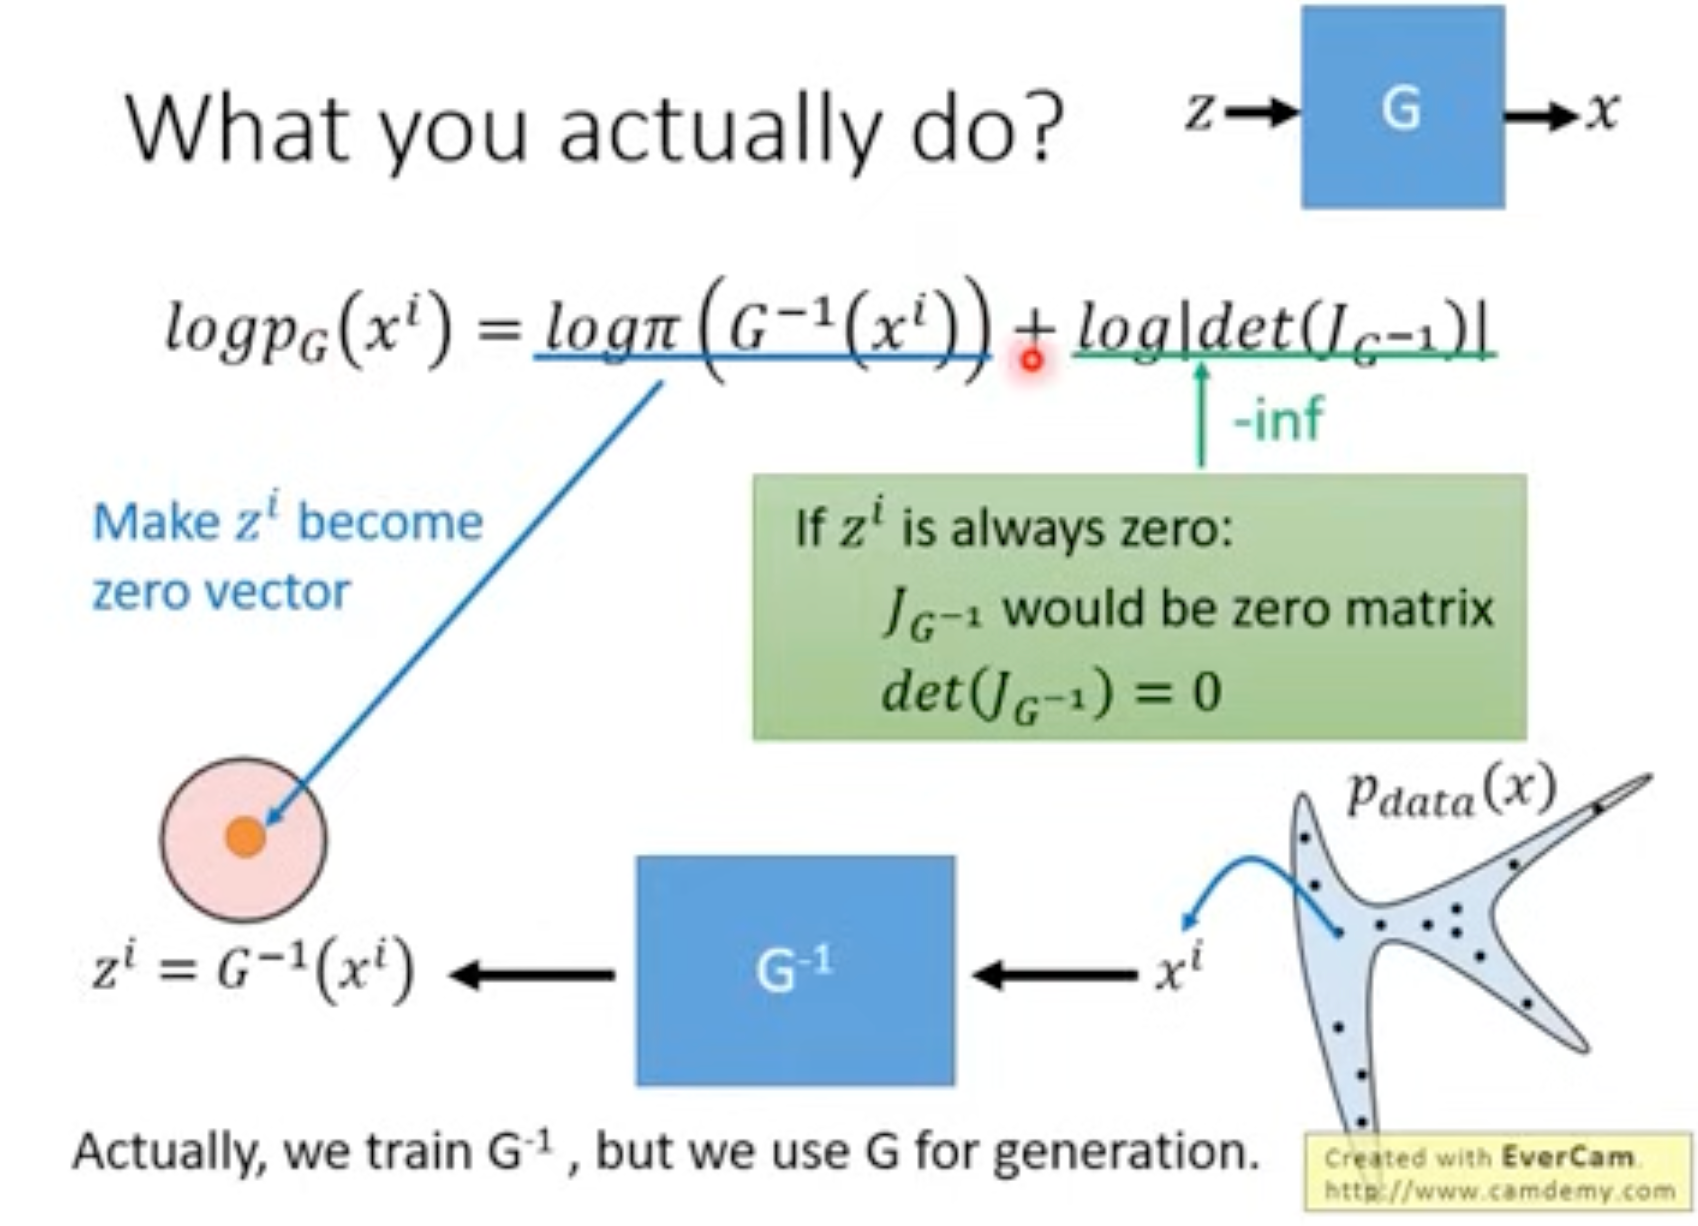
代入最开始设定的优化目标,如式所示:
G∗=argGmaxi=1∑mlogpG(xi)
等价于:
G∗=argGmaxi=1∑m[logπ(G−1(xi))+log∣det(JG−1)∣]
对于展开式,存在两个问题:
- J的维度等于 z 和 x 的乘积,大维度下计算determinant比较困难=> 设计好Generator
- 因为训练时需要计算 G−1,(G−1而非G是训练网络) ;确保G 要 invertible,需要限制 z 和 x 的维度相同。在 GAN 中 z 的维度远小于 x。
G has limitations, 需要更多G
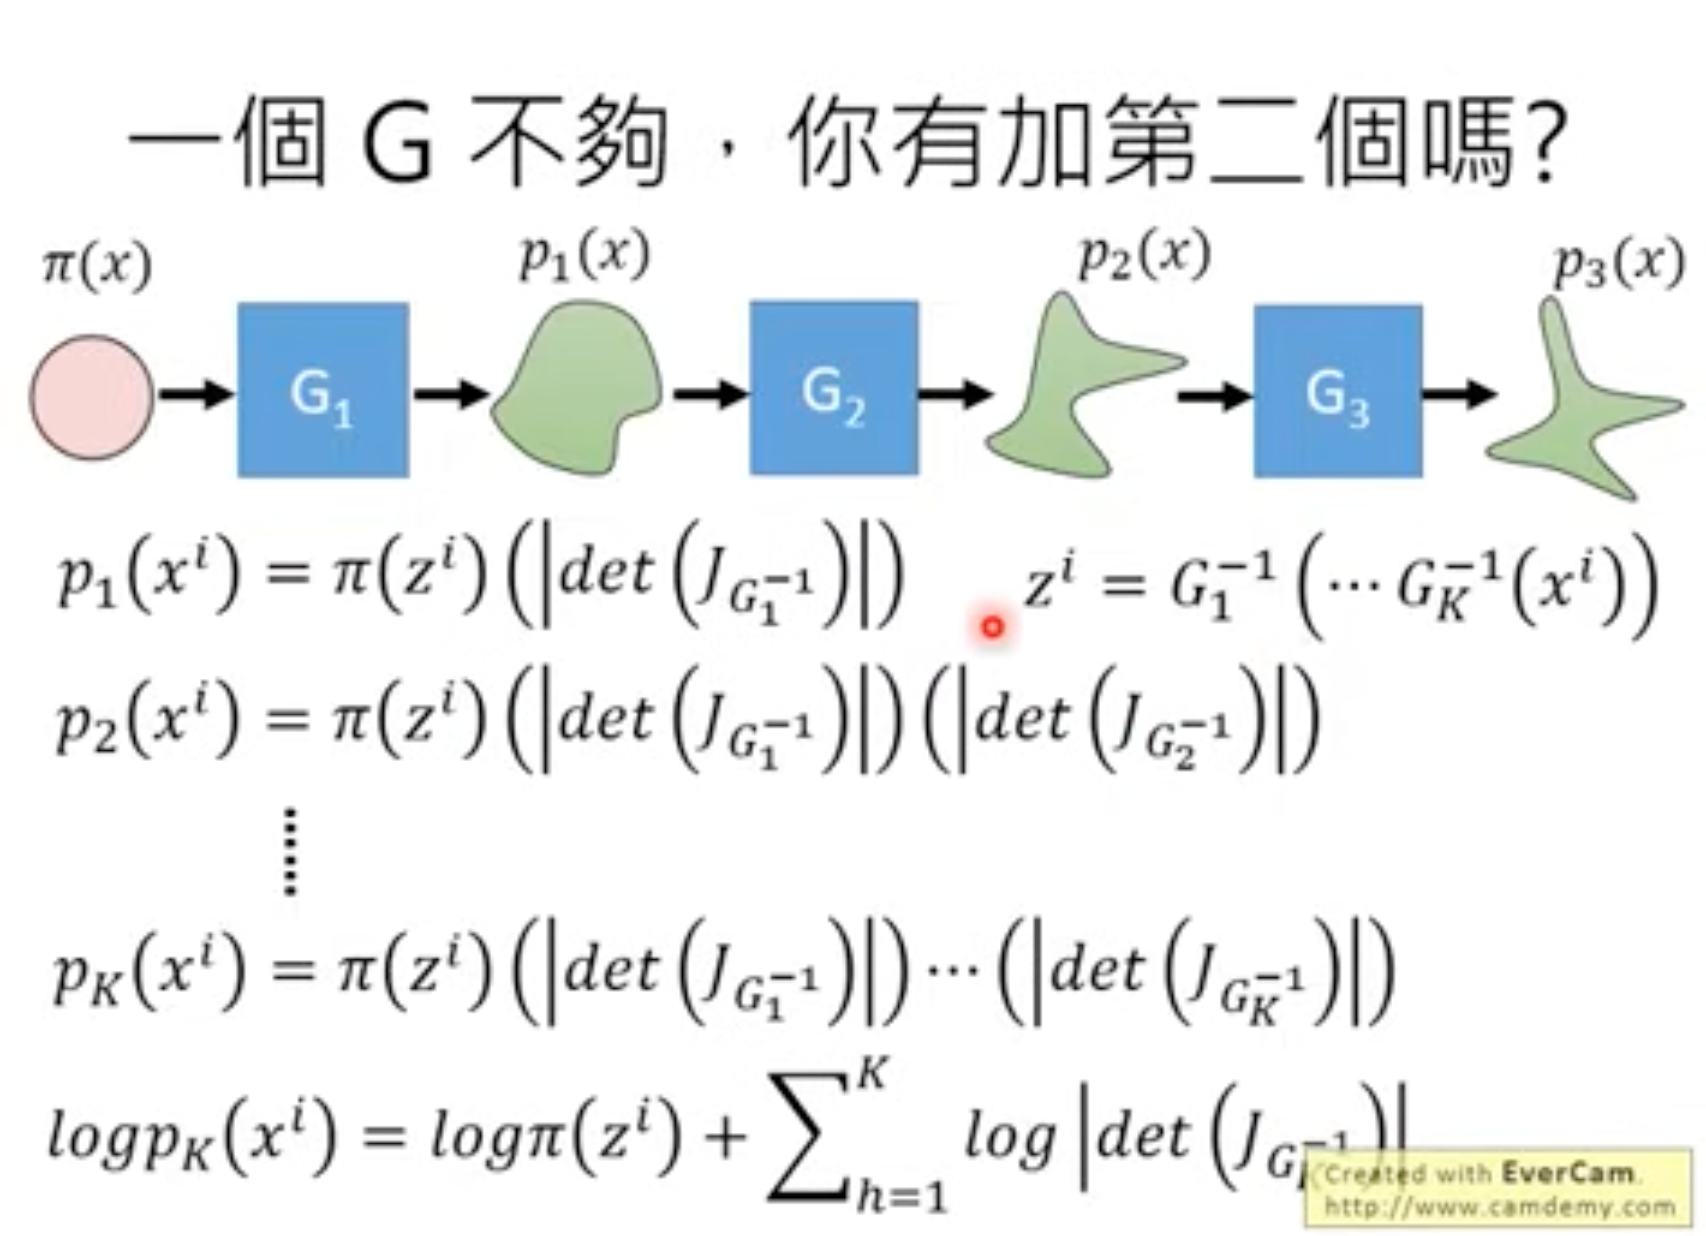
 基于此,设计的 Coupling Layer 如下图所示
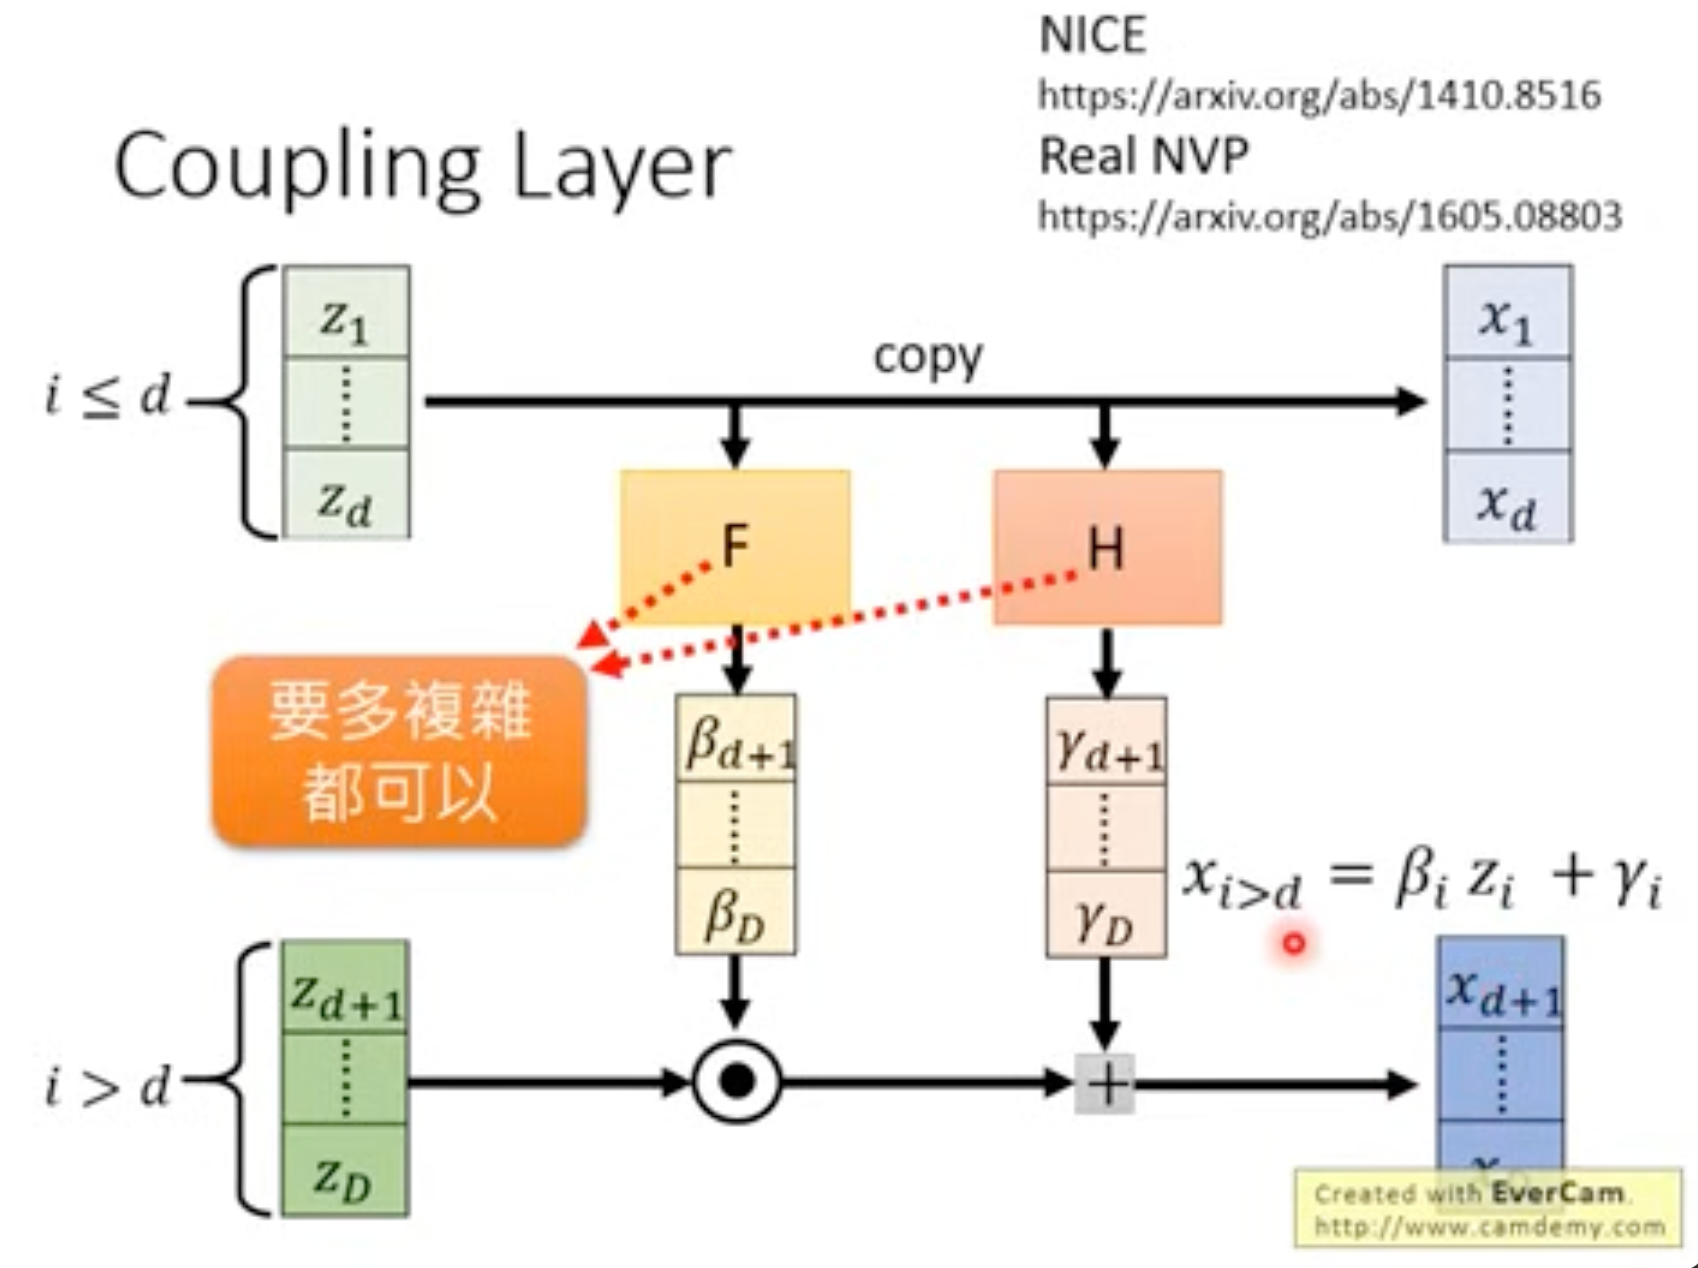
其中,网络 F 和 H 可以任意复杂,不影响 G 的可逆性。这种新颖的 网络结构 解决了上述两个问题:
- 针对求 G−1,可以直接使用以下公式求解:
zi≤d=xi,zi>d=βixi−γi
- 针对计算 det(JG−1),将 Jacobian matrix 列出:
| JG | z1 | z2 | … | zd | zd+1 | … | zD |
|---|
| x1 | I (Identity) | - | - | - | O (Zero) | - | - |
| x2 | - | - | - | - | - | - | - |
| ⋮ | - | - | - | - | ⋮ | - | - |
| xd+1 | Don't care | - | - | - | Diagonal | - | - |
| ⋮ | - | - | - | - | ⋮ | - | - |
| xD | - | - | - | - | - | - | - |
解析
可见,这种将 1∼d 维的向量直接拷贝的做法,使得雅各比矩阵的秩等于右下角的对角子矩阵,而该部分的秩等于 β 的乘积:
det(JG−1)=∂zd+1∂xd+1⋅∂zd+2∂xd+2⋯∂zD∂xD=i=d+1∏Dβi
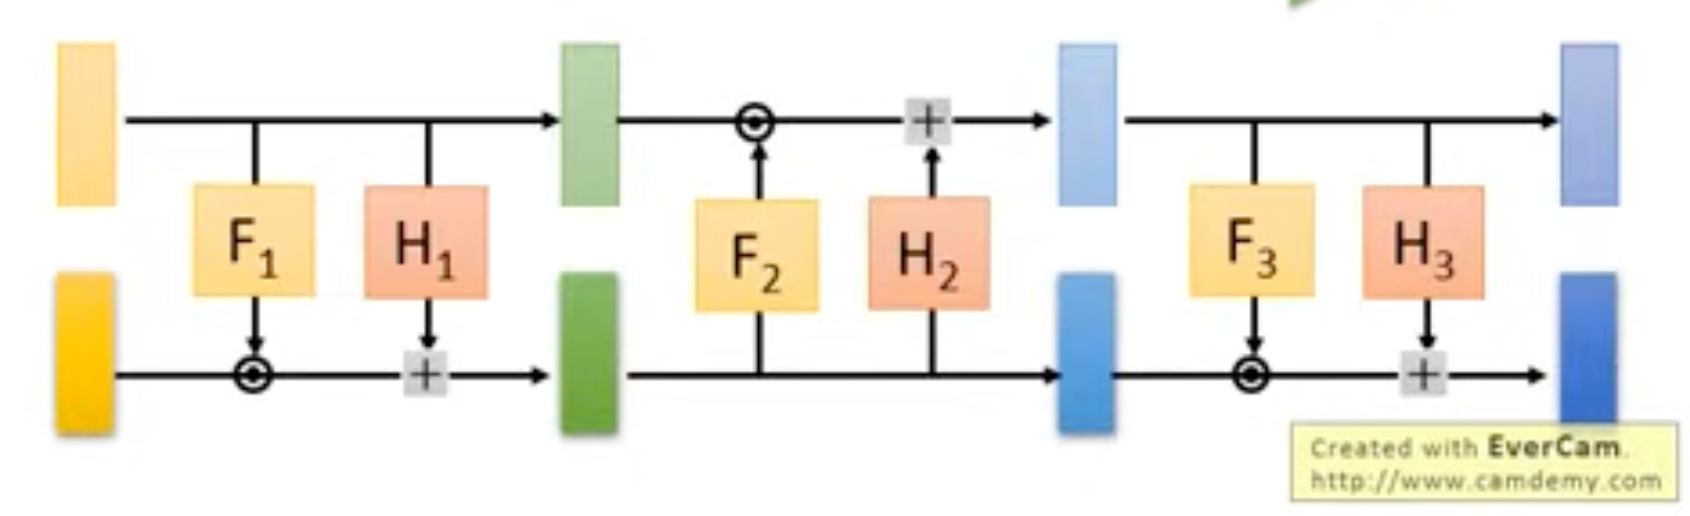
为增加网络的复杂性,需要堆叠多个 G−1,但是会造成一个问题:1∼d 维的向量始终是不变的。为此,可以设置网络结构交替取反,如下图所示:
1×1 convolution
Google 提出了 Glow (arxiv.org/abs/1807.03039),将 Flow-based model 做到与 GAN 相媲美,主要的创新点包括 Coupling Layer 和 1×1 convolution,后者在目前的网络设计中十分常见,主要用来 shuffle channels,但它也可以被视作一种 Flow-based model。
对于 RGB 图像
设置卷积核 W 大小为 3×3,为了尽量使 W 是可逆的,作者使用了一个可逆的 3×3 矩阵进行初始化,同时方便计算W−1 和 det(W)。针对 Flow-based model 损失函数中的 G−1,可以套用公式计算 W 的逆矩阵;针对 det(JG−1),如下表所示:
| JG−1 | z1,1(1) | z1,1(2) | z1,1(3) | … | zn,m(1) | zn,m(2) | zn,m(3) |
|---|
| x1,1(1) | | | | … | Zeros | Zeros | Zeros |
| x1,1(2) | | W | | … | Zeros | Zeros | Zeros |
| x1,1(3) | | | | … | Zeros | Zeros | Zeros |
| ⋮ | ⋮ | ⋮ | ⋮ | ⋱ | ⋮ | ⋮ | ⋮ |
| xn,m(1) | Zeros | Zeros | Zeros | … | | | |
| xn,m(2) | Zeros | Zeros | Zeros | … | | W | |
| xn,m(3) | Zeros | Zeros | Zeros | … | | | |
| | | | | | | |
| | | | | | | |
| x=f(z)=Wz | | | | | | | |
| => Jf=W | | | | | | | |
容易发现:
det(JG−1)=det(W)n×m
更多
Parallel WaveNet
WaveGlow