Deep Learning
Bias 和 Variance 辨析
- Bias (偏差): 偏差衡量的是模型预测的期望值与真实值之间的差距。它反映了模型本身的拟合能力或者说对问题的假设是否准确。
- Variance (方差): 方差衡量的是模型在不同训练集上给出的预测值的波动程度。它反映了模型对训练数据波动的敏感性。
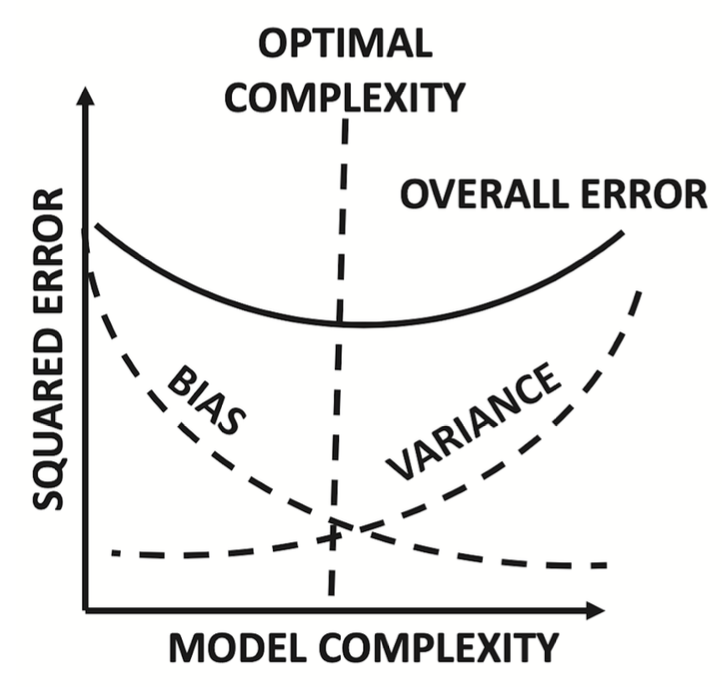
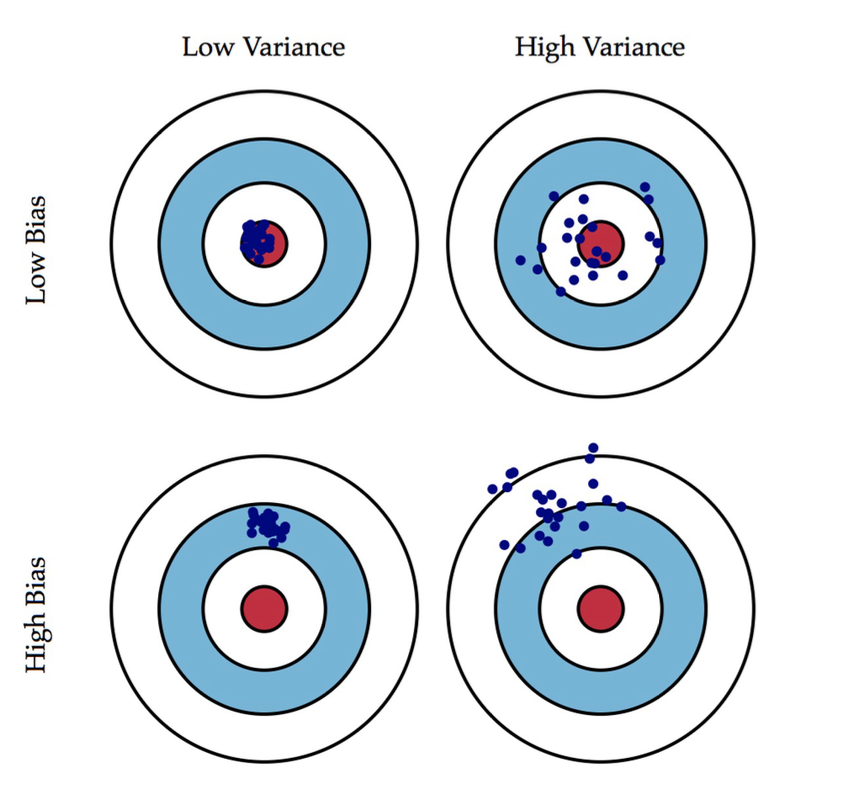 Bias 和 Variance 是误差分解中的两个核心来源,通常存在此消彼长的关系:
- 高 Bias、低 Variance: 往往对应欠拟合 (underfitting)。
- 低 Bias、高 Variance: 往往对应过拟合 (overfitting)。
Overfitting: model performs well on training data but does not generalize well to unseen data (test data) Underfitting: model is not complex enough to capture pattern in the training data well and therefore suffers from low performance on unseen data
实践中的平衡思路:
- 当模型欠拟合 (高 Bias) 时:提高模型容量、增加有效特征、减弱正则化。
- 当模型过拟合 (高 Variance) 时:增加数据量、加强正则化、使用数据增强或早停。
Regularization
Regularization(正则化)本质上就是一种牺牲一点点 Bias(故意让模型拟合得不那么完美)来大幅度降低 Variance(让模型更稳定) 的策略。它的核心目标是提升模型在未知数据上的泛化能力(Generalization)。
最经典的是针对权重参数 的 L1 和 L2 正则化:
- L1 正则化 (Lasso Regression)
- 在损失函数后加上所有权重绝对值的和,即 。
- 特点: L1 会促使模型中的很多权重变成绝对的 。因此,它自带特征选择(Feature Selection) 的功能,能够产出一个“稀疏(Sparse)”的模型,非常适合高维但只有少数特征起作用的场景。
- L2 正则化 (Ridge Regression / Weight Decay)
- 在损失函数后加上所有权重的平方和,即 。
- 特点: L2 会把模型的所有权重都往 的方向拉,但很少会让它们真正变成 。它倾向于让所有特征都发挥一点点作用,避免某个单一特征的权重过大(也就是让权重分布更平滑),这在训练深度神经网络时极为常用(通常被称为 Weight Decay)。
除了直接惩罚权重,在构建复杂的神经网络(如LLM)时,还会使用一些架构或训练流程上的正则化技巧:
- Dropout: 在训练过程中,每次随机“丢弃”(将激活值设为零)一部分神经元。这迫使网络不能过度依赖某几个特定的神经元,从而增强鲁棒性。
- Early Stopping(早停): 监控验证集(Validation Set)的误差。当发现训练集误差还在下降,但验证集误差开始上升(说明开始过拟合了)时,立刻停止训练。
- Data Augmentation(数据增强): 通过对训练数据进行微小的改变(如图像翻转、文本加噪)来人为扩大训练集,数据越多,模型越不容易过拟合。
Performance Metrics
• Algorithmic performance: accuracy, precision, recall, F1-score, ROC, • System performance: training bme, inference bme, training cost, memory requirement, training efficiency
Confusion Matrix (混淆矩阵)
二分类任务里常用混淆矩阵来理解模型在“正/负”上的错误类型:
| 实际 \ 预测 | 预测为正 (Positive) | 预测为负 (Negative) |
|---|---|---|
| 实际为正 (Positive) | TP (True Positive) | FN (False Negative) |
| 实际为负 (Negative) | FP (False Positive) | TN (True Negative) |
常见指标:
Accuracy 准确率
在正负样本极度不平衡的数据集中(比如罕见病检测),这个指标具有欺骗性
Precision 精确率
Precision 精确率 = 标出来的有多少是真的 → 注重“查准”。
- 假发现率 (False discovery rate) =
Recall 召回率
Recall 召回率 = 真实有多少被查到了 → 注重“查全”
- 召回率在医学和统计学中也常被称为 灵敏度 (Sensitivity) 或 真阳性率 (True positive rate, TPR)
两者往往相互影响:
想召回更多,就会多标一些,但可能会带来更多误报 → 精确率下降 想保持精确率,就严格筛选,但可能漏掉一些 → 召回率下降
所以常见用 F1-Score 衡量两者平衡:
Harmonic mean of precision and recall; measure of classifier accuracy
F1 Score
F1 score: Harmonic mean of precision and recall; measure of classifier accuracy
score: is F1 score; recall is considered times as important as precision
Specificity 特异度
- 含义: 在所有真实的“负”样本中,模型成功认出了多少。也可以称为 真阴性率 (True negative rate, TNR)。
- 假阳性率 (False positive rate, FPR) = 。
Balanced accuracy 平衡准确率
它综合考虑了混淆矩阵中的所有条目(同时兼顾了正类和负类的预测表现),值介于 (最差的分类器)和 (最好的分类器)之间。
训练流程
Forward Phase
- compute the activations of the hidden units based on the current value of weights
- calculate output
- calculate loss function
Backward Phase
- compute partial derivative of loss function w.r.t. all the weights;
- use backpropagation algorithm to calculate the partial derivatives recursively
- backpropagation changes the weights (and biases) in a network to decrease the loss
Q:为什么每一次 backward 之前都要把梯度置零?
在 PyTorch 中,梯度默认是累加而不是自动覆盖的。 每次调用 loss.backward(),新计算得到的梯度都会加到参数的 .grad 上。如果不在每次反向传播前清零,梯度就会跨 iteration 叠加,导致参数更新不再只基于当前 batch,从而引入错误的优化方向。 因此,在标准训练流程中,我们会在每次 backward 前调用 optimizer.zero_grad(),确保当前参数更新只使用本轮 forward 对应的梯度。 这种设计也是为了支持像梯度累积这样的场景,例如在显存受限时,用多个小 batch 累加梯度来等效一个大 batch。
Q:with torch.no_grad() 的作用是什么?
在 PyTorch 中,默认情况下张量运算会被 autograd 跟踪,用于反向传播。 使用 torch.no_grad() 可以显式告诉框架当前不需要梯度计算,这不仅避免了无用的计算图构建,还能显著降低中间激活的显存开销,因此在 inference、validation、test 阶段是标准做法。
Gradient Descent
- Update the weights using gradient descent
Stochastic Gradient Descent (SGD)
- Loss is calculated using one training data at each weight update.
- Stochastic gradient descent is only a randomized approximation of the true loss function.
梯度检查
梯度累积
Hyperparameters
Network architecture
number of hidden layers, number of hidden units per layer
Activation functions
Weight initializer
Learning rate
Batch size
Batch size 指的是一次前向传播和反向传播中同时参与计算的样本数量。在训练过程中,模型会先对一个 batch 的数据进行 forward,计算该 batch 的平均(或总)loss,然后基于这个 loss 做一次 backward,得到梯度并更新参数。
大 Batch Size 可以让梯度估计更准确,允许使用更大的学习率来加快收敛。但缺点是容易让模型陷入“尖锐的局部最优解(Sharp minima)”,导致模型在未知数据上表现糟糕(泛化能力差)。 而小批量数据带来的梯度计算带有一定的随机噪声。这种噪声不但不是坏事,反而起到了隐式正则化(Implicit regularization)的作用,能把模型“震出”那些尖锐的局部最优坑,帮助它找到更平缓、泛化能力更强的“平坦最优解(Flat minima)”
苏剑林. (Nov. 14, 2024). 《当Batch Size增大时,学习率该如何随之变化? 》[Blog post]. Retrieved from https://kexue.fm/archives/10542 苏剑林. (Sep. 01, 2025). 《重新思考学习率与Batch Size(一):现状 》[Blog post]. Retrieved from https://kexue.fm/archives/11260
Momentum
Optimizer
Quantization 量化
| Format | Bits | Exponent | Fraction | Memory needed to store one value |
|---|---|---|---|---|
| FP32 | 32 | 8 | 23 | 4 bytes |
| FP16 | 16 | 5 | 10 | 2 bytes |
| BFLOAT16 | 16 | 8 | 7 | 2 bytes |
| INT8 | 8 | — | 7 | 1 byte |
- Reduce required memory to store and train models.
- Statistically projects 32-bit floating point numbers into lower precision spaces.
- Quantization-aware training (QAT) learns the quantization scaling factors during training.
- BFLOAT16 is a popular choice.
AMP(Automatic Mixed Precision)自动混合精度
AMP 是一种训练加速技术,通过在训练过程中自动混合使用 FP16 / BF16 和 FP32,在几乎不损失模型精度的前提下,显著提升训练速度并降低显存占用。
Q: 为什么 AMP 能提升性能?
FP16 / BF16 计算更快 现代 GPU(如 V100 / A100 / H100)对低精度运算有 Tensor Core 硬件加速,矩阵乘和卷积的吞吐量明显高于 FP32。
显存占用更低 FP16 仅占 FP32 一半显存,使得同显存可使用更大的 batch size 或在相同 batch 下训练更大的模型
计算与访存效率更高 更小的数据类型减少显存带宽压力,在大模型或大 batch 训练中尤为明显。
Q: AMP 为什么不会明显降低精度?
- 选择性的混合精度:
大部分算子(如卷积、GEMM)使用 FP16 / BF16
数值敏感操作(如 loss 计算、LayerNorm 归一化、Softmax、梯度累积)仍然使用 FP32
- 通过 Loss Scaling 解决 FP16 梯度下溢问题
- 在反向传播前,先将 Loss 乘以一个很大的系数(比如 )避免梯度变成 0。根据链式法则,所有的梯度都会被等比例放大,从而跳进
float16能够表达的数值区间。更新参数前再缩放回来。
AMP 的 forward 阶段本身是安全的,真正的数值风险发生在 backward 时的 FP16 梯度。虽然权重梯度最终是在 FP32 中计算的,但如果 activation 梯度在 FP16 中已经 underflow 成 0,那么再精确的 FP32 计算也无济于事。 GradScaler 的作用正是通过放大 loss,防止这一关键梯度在反向传播早期消失。
EMA
模型使用正常的权重(受 AMP 缩放影响的梯度更新)进行反向传播 影子权重(Shadow Weights): 另外维护一套权重的“影子副本”,它不是通过梯度直接更新,而是通过 EMA 公式缓慢跟随:
其中 通常设为 或 。
提升泛化能力与稳定性 AMP 虽然快,但由于舍入误差,单步更新可能存在较大的随机性。EMA 通过累积历史权重的平均值,相当于在参数空间做了一种“平滑”,能够过滤掉 AMP 带来的部分数值噪音,使模型最终收敛在更平坦、更稳定的局部极小值点。
解决测试集表现波动 在混合精度训练中,验证集(Validation)的指标有时会剧烈抖动。使用 EMA 权重进行预测(Inference)通常能比直接使用最新训练权重获得更高的精度和更稳健的表现。
协同解决数值溢出 AMP 使用 GradScaler 来防止梯度消失/溢出。配合 EMA 使用时,EMA 权重作为一种“慢更新”机制,能有效防止某些由于梯度骤变(Spike)导致的模型崩溃。
显存开销更大 EMA 需要为模型参数维护一份额外的 float32 副本。在 AMP 节省显存的同时,EMA 会消耗一部分显存(通常是模型大小的一倍)。