Distributed Training
Scaling
Evaluating Modern GPU Interconnect: PCIe, NVLink, NV-SLI, NVSwitch and GPUDirect
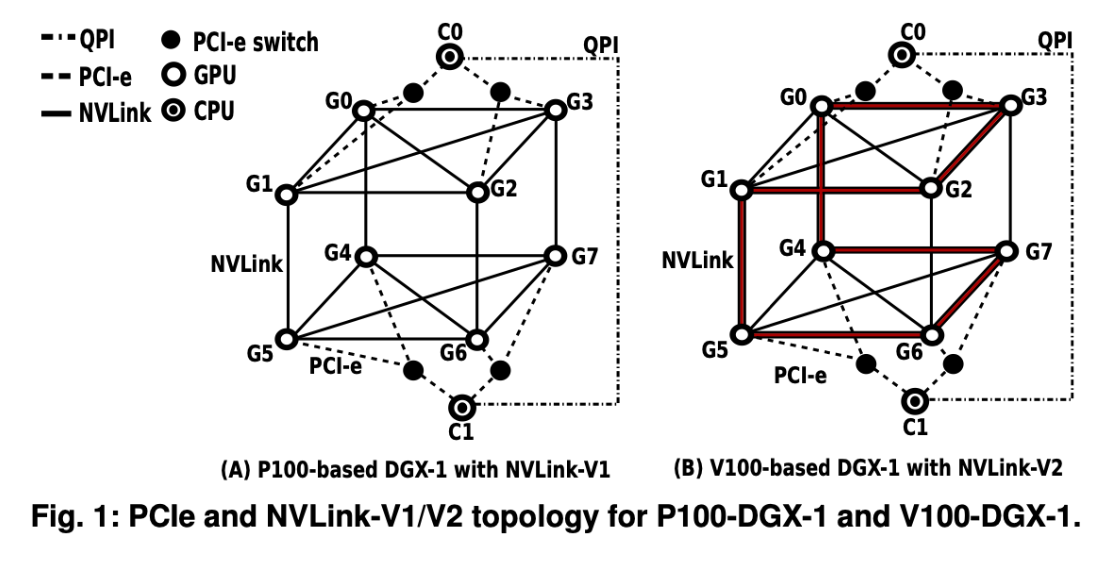
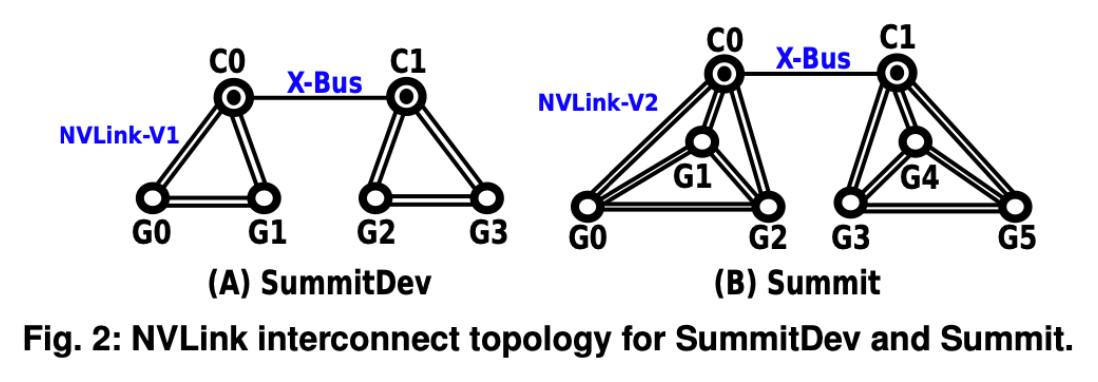
Verbcal scaling-up in a single node 垂直扩展 / 向上
- 在单台物理机(Node)内增加 GPU 的数量。
- 单机内多卡的通信瓶颈通常在于主板总线。
- NVLink 技术提供了比传统 PCIe 高得多的带宽,使得单机内的几块 GPU 之间能够极快地共享数据和同步梯度。
- X-Bus 是 IBM 的总线技术,专门用来在同一个主板上连接这两个 CPU, 类似 Intel 处理器之间的 QPI / UPI 总线,或者是 AMD 处理器之间的 Infinity Fabric
Horizontal scaling-out across multiple nodes 水平扩展 / 向外
- 当单台机器(即使装了 8 张或 16 张卡)的算力或显存依然不够时,就需要通过高速网络(如 InfiniBand)把成百上千台机器连接成一个集群。
- e.g. GPU accelerated supercomputers like Summit and Sierra from US Department of Energy
High Performance Networking
SMP: symmetric multiprocessing
- 主板上的所有 CPU 核心地位平等。它们共享同一片物理内存(RAM)、同一个操作系统以及所有的 I/O 总线。
- QPI: Quick-path interconnect (早期 25.6 GB/s)
- CPU 内部或 CPU 之间的高速点对点总线
PCIe: Peripheral Component Interconnect express
- 连接 CPU 与外部硬件设备(显卡 GPU、高速固态硬盘 NVMe SSD、万兆网卡甚至 InfiniBand 网卡)的高速串行扩展总线标准
Large Scale Parallel and Deep Learning applications needs:
- High Bandwidth (高带宽)
- Low Latency (低延迟)
| Network technology | Bandwidth [Gb/s] | Latency [us] |
|---|---|---|
| 10GigE | 10 | 4 |
| 40GigE | 40 | 4 |
| IB EDR | 100 | 1 |
| NVLink | > 400 | 0.1-0.2 |
Ethernet is not enough
- 虽然万兆(10GigE)或四万兆(40GigE)以太网在日常服务器中已经很快了,但它的**延迟(Latency)**通常在 4 微秒左右,而且依赖 CPU 处理庞大的 TCP/IP 协议栈,这会消耗极大的计算资源并带来不可预测的延迟抖动
Infiniband (IB) is widely adopted
- 相比以太网,IB 网络(如表中的 EDR 版本)不仅带宽更高,更关键的是它的延迟极低(约 1 微秒),并且支持 RDMA(远程直接内存访问) 技术。这意味着一台机器的网卡可以直接读写另一台机器的内存(或显存),完全绕过 CPU 和操作系统的内核,极大地提升了跨节点(Scale-out)通信的效率
Custom Networks are the best
- NVLink 的带宽远超普通的 IB 网络,且延迟极低(0.1-0.2 微秒)。这就是为什么在单台物理机内部(Scale-up),NVIDIA 坚持要用自家的 NVLink 将 GPU 互联,而不是走传统的 PCIe 或普通网络
| 代数 / 世代 | PCIe (x16 双向总带宽) | 对应的 NVIDIA 架构 | NVLink (单卡双向总带宽) | 性能差距倍数 |
|---|---|---|---|---|
| 第 1 代 (2016) | PCIe 3.0: 32 GB/s | Pascal (P100) | 160 GB/s | 5 倍 |
| 第 2 代 (2017) | PCIe 3.0: 32 GB/s | Volta (V100) | 300 GB/s | 9.3 倍 |
| 第 3 代 (2020) | PCIe 4.0: 64 GB/s | Ampere (A100) | 600 GB/s | 9.3 倍 |
| 第 4 代 (2022) | PCIe 5.0: 128 GB/s | Hopper (H100) | 900 GB/s | 7 倍 |
| 第 5 代 (2024) | PCIe 6.0: 256 GB/s | Blackwell (B200) | 1.8 TB/s (1800 GB/s) | 7 倍 |
| 第 6 代 (2026)* | PCIe 7.0: 512 GB/s | Rubin | 3.6 TB/s (3600 GB/s) | 7 倍 |
6D 并行是什么?
- Data Parallel(DP)
- Tensor Parallel(TP)
- Pipeline Parallel(PP)
- Sequence Parallel(SP)
- Expert Parallel(EP)
- Optimizer Parallelism (ZeRO-style 状态分片)
Model Parallelism
Splitting the model across multiple learners
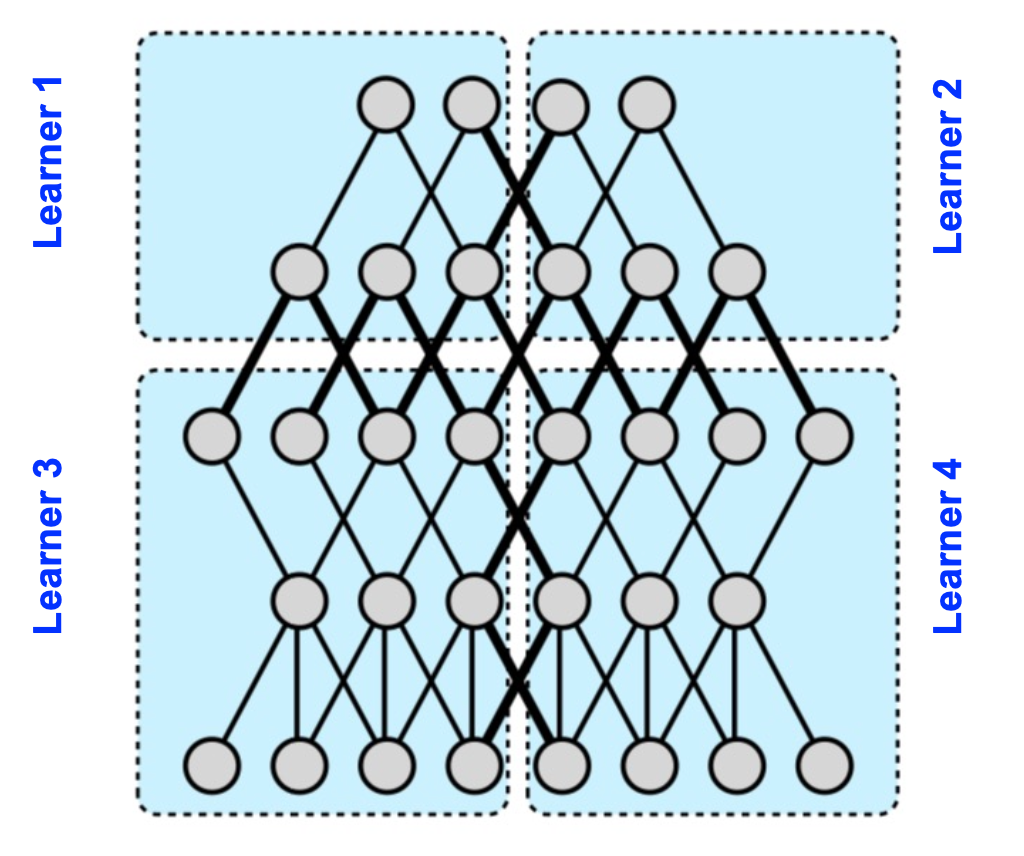 性能很大程度取决于网络的连接结构和操作计算量需求,适合计算密集且局部连接性强的场景:
- Each machine handles a subset of computation
- Low network traffic
Pipeline Parallelism
GPipe Pipelining
A pipeline parallelism open-source library that allows scaling any network that can be expressed as a sequence of layers. GPipe: Easy Scaling with Micro-Batch Pipeline Parallelism
将全局批次(global batch)拆分为多个微批次 (micro-batches),并将它们并发地注入到流水线中。
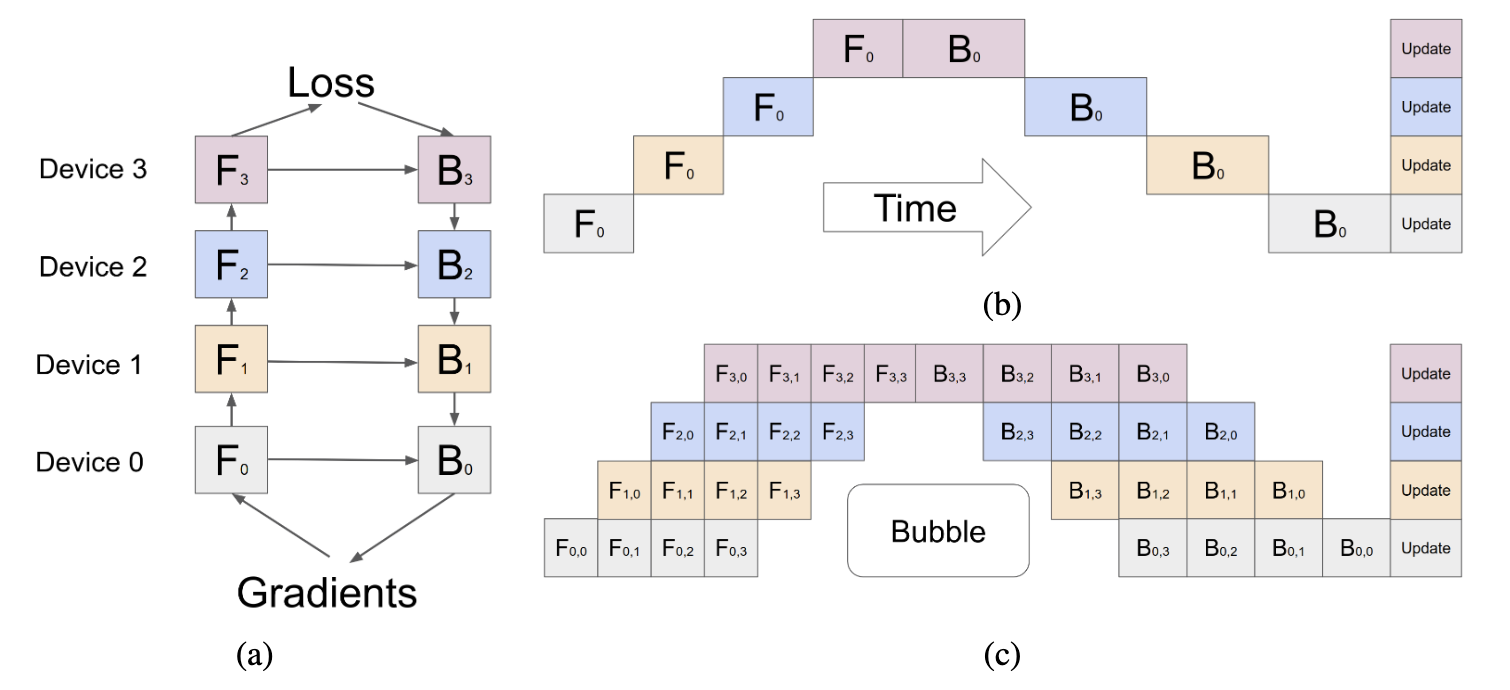
流水线气泡 (Pipeline Bubble)
在图 (b) 中,如果 Device 0 把第一批数据算完传给 Device 1 后,它自己就只能干等着,直到 Device 3 算完前向和反向,把误差传回来,Device 0 才能开始算反向梯度。中间大段的空白时间被称为 "Bubble",这会导致 GPU 算力的极大浪费
微批次 Micro-batch
为了填补这些气泡,图 (c) 将原本一个大的 Batch 切成了 4 个极其微小的块 ( 到 )。Device 0 算完第一小块,传给 Device 1 的同时,自己立马开始算第二小块。这样大家就“流水”般地忙碌了起来,大大提高了 GPU 的利用率。
对内存不友好,且在面对大批次时扩展性差
为了计算反向传播(求导),GPU 必须把前向传播时的中间结果(激活值)存在显存里。由于微批次导致反向计算被严重推迟,设备不得不缓存大量微批次的激活值。这导致内存需求与并发调度的微批次数量 () 成正比,时间复杂度为 。
如何解决激活值显存占用?
以 Amazon Sagemaker 为例,
- Pipeline & Tensor Parallelism(流水线切分层,张量切分矩阵)
- Optimizer state sharding(优化器状态分片 ZeRO)
- Activation offloading & checkpointing
这正是解决 GPipe 显存爆炸问题的方案。
Checkpointing (激活重计算): 只在每隔几层的地方存一个“存档点(Checkpoint)”,把中间的激活值全抛弃以节省显存。等反向传播算到时再从存档点出发,临时重新计算(Recompute)一遍被扔掉的值。这本质上是用时间(额外的计算量)换空间(显存)。
Offloading (卸载): 实在装不下的时候,趁 GPU 还在算别的,把一些暂时不用的数据存到 CPU 的内存里,需要时再搬回来。
https://docs.aws.amazon.com/sagemaker/latest/dg/model-parallel-intro.html
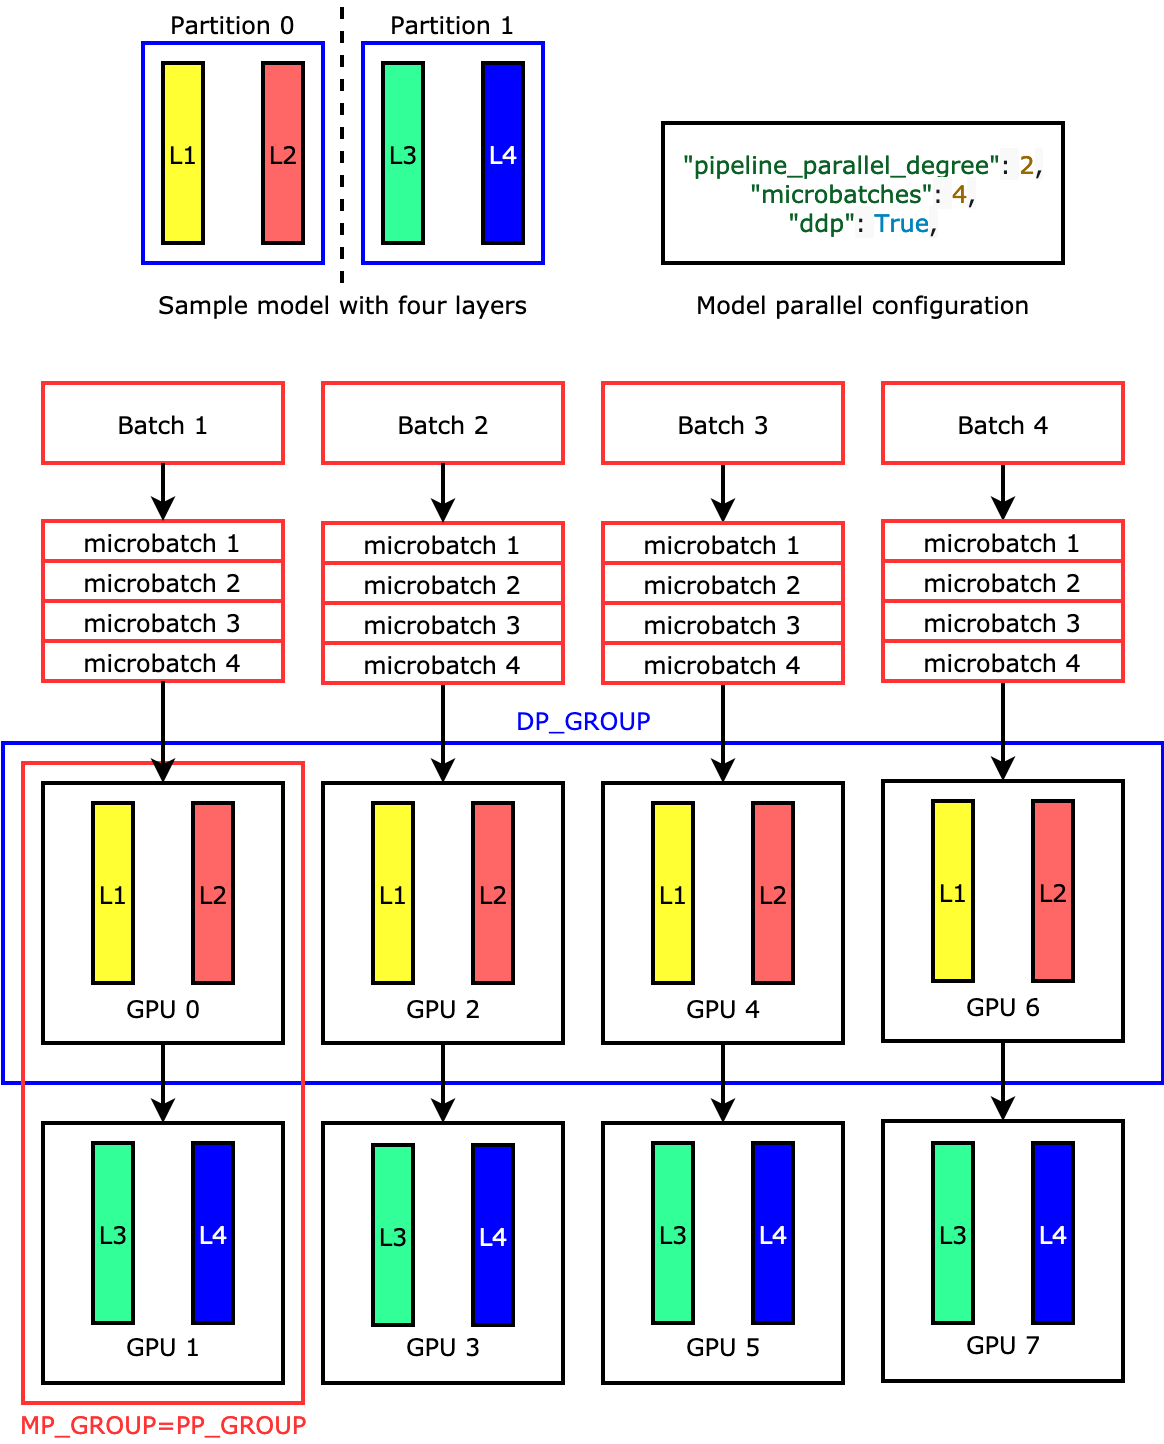
如图,一个包含 4 个Layer的模型,在 8 张 GPU 上混合使用数据并行和流水线并行 每个模型副本是一个 PP_GROUP (pipeline parallel group 流水线并行组),并且被横跨划分在两张 GPU 上。例如图中红框的 GPU 0 和 GPU 1 共同持有一份完整的模型。 模型的每个切分部分被分配给 4 张 GPU,这 4 个切分副本构成一个数据并行组,标记为 DP_GROUP。例如图中蓝框的 GPU 0, 2, 4, 6 都持有 L1 和 L2 层,它们之间做数据并行同步。
Tensor Parallelism
Splits individual layers, or
nn.Modules, across devices, to be run in parallel
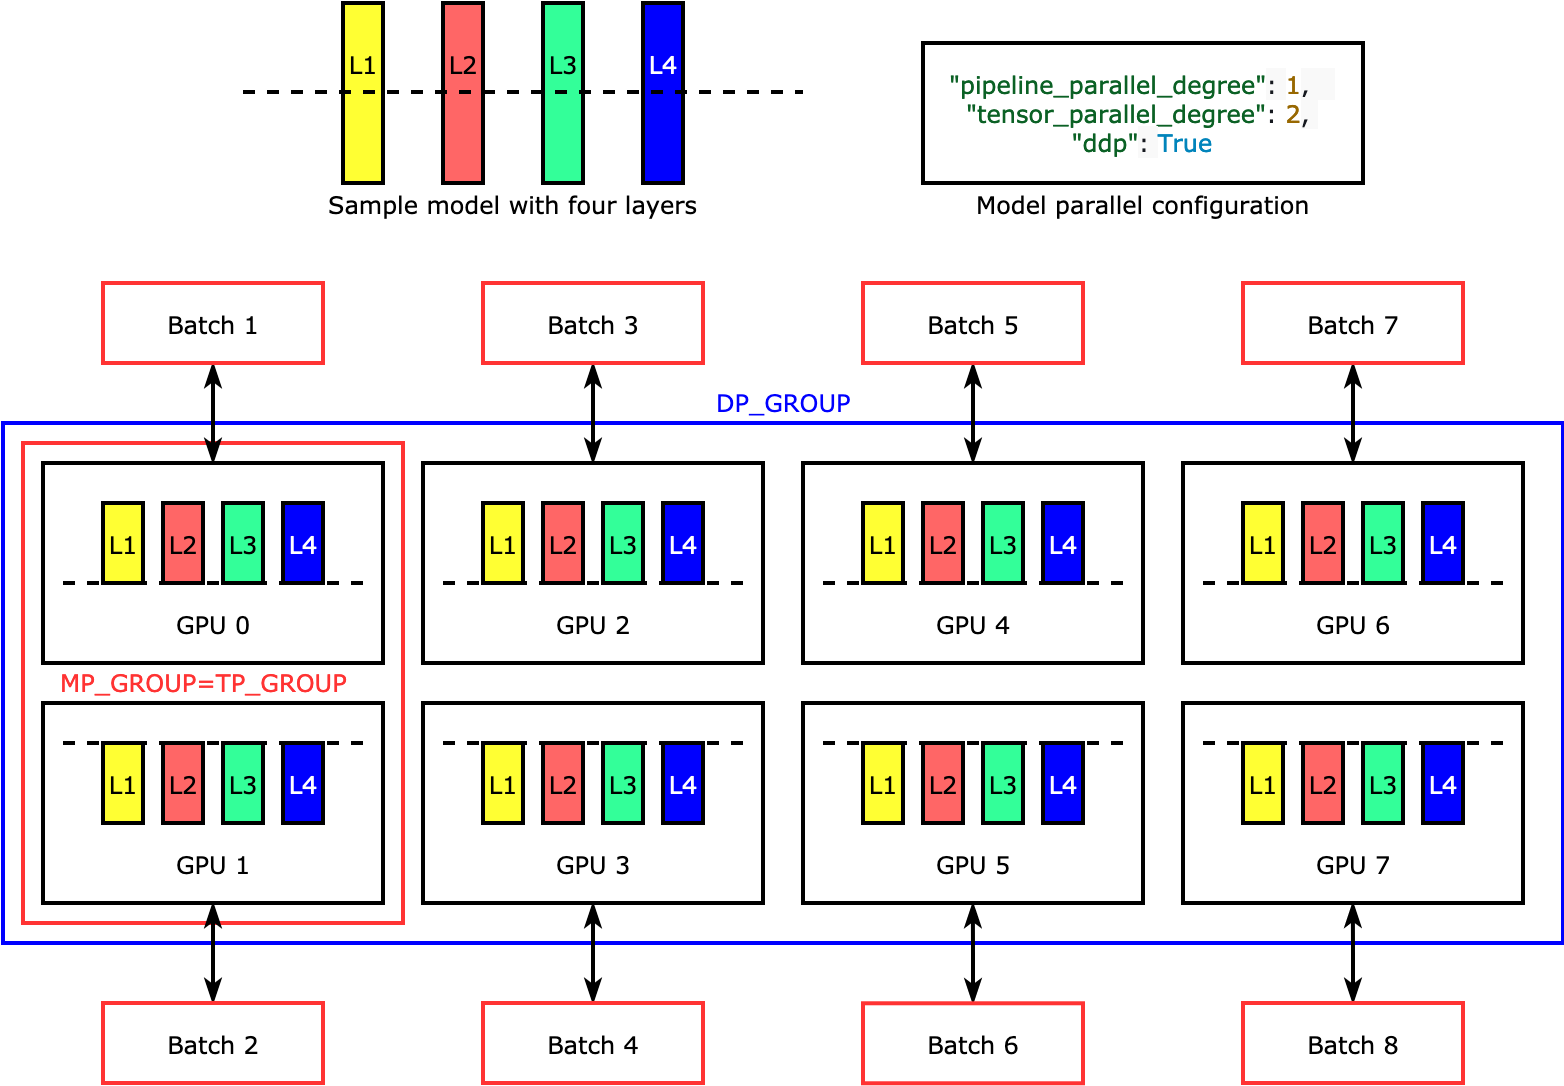
和流水线并行按层的前后顺序切分不同,张量并行是把每一层内部的参数矩阵给切开了(即图中的水平虚线)。比如 GPU 0 拿到了 L1、L2、L3、L4 这四层的所有“上半部分”参数,而 GPU 1 拿到了它们的“下半部分”。
图中的红框标出了 MP_GROUP = TP_GROUP。GPU 0 和 GPU 1 组成了一个团队。在做前向或反向传播时,它们必须极其频繁地交换数据(通常在算完半个矩阵后,立刻通过 All-Reduce 把结果加起来)。故而张量并行通常只在同一台拥有极高 NVLink 带宽的物理机内部进行。
个人理解:Batch1 和 Batch2 数据相同,图中数据并行度为4
Data Parallelism
- Model is replicated on different learners
- Data is sharded and each learner work on a different pariion
- Helps in efficient training with large amount of data
- Parameters (weights, biases, gradients) from different replicas need to be synchronized 在每一次反向传播(Backward)结束、准备更新权重之前,所有的卡必须停下来互相通信。通过 All-Reduce 算法(通常基于 NCCL 库),把所有卡上的梯度加起来求一个平均值,统一用这个平均梯度去更新权重。 梯度的“同步”过程,对机器之间的网络带宽要求极高。 如果模型稍微大一点,导致每张卡的显存都被“优化器状态”占满了,就会引入 ZeRO (优化器状态分片) 来改造标准的数据并行
Optimizer state sharding 优化器状态分片
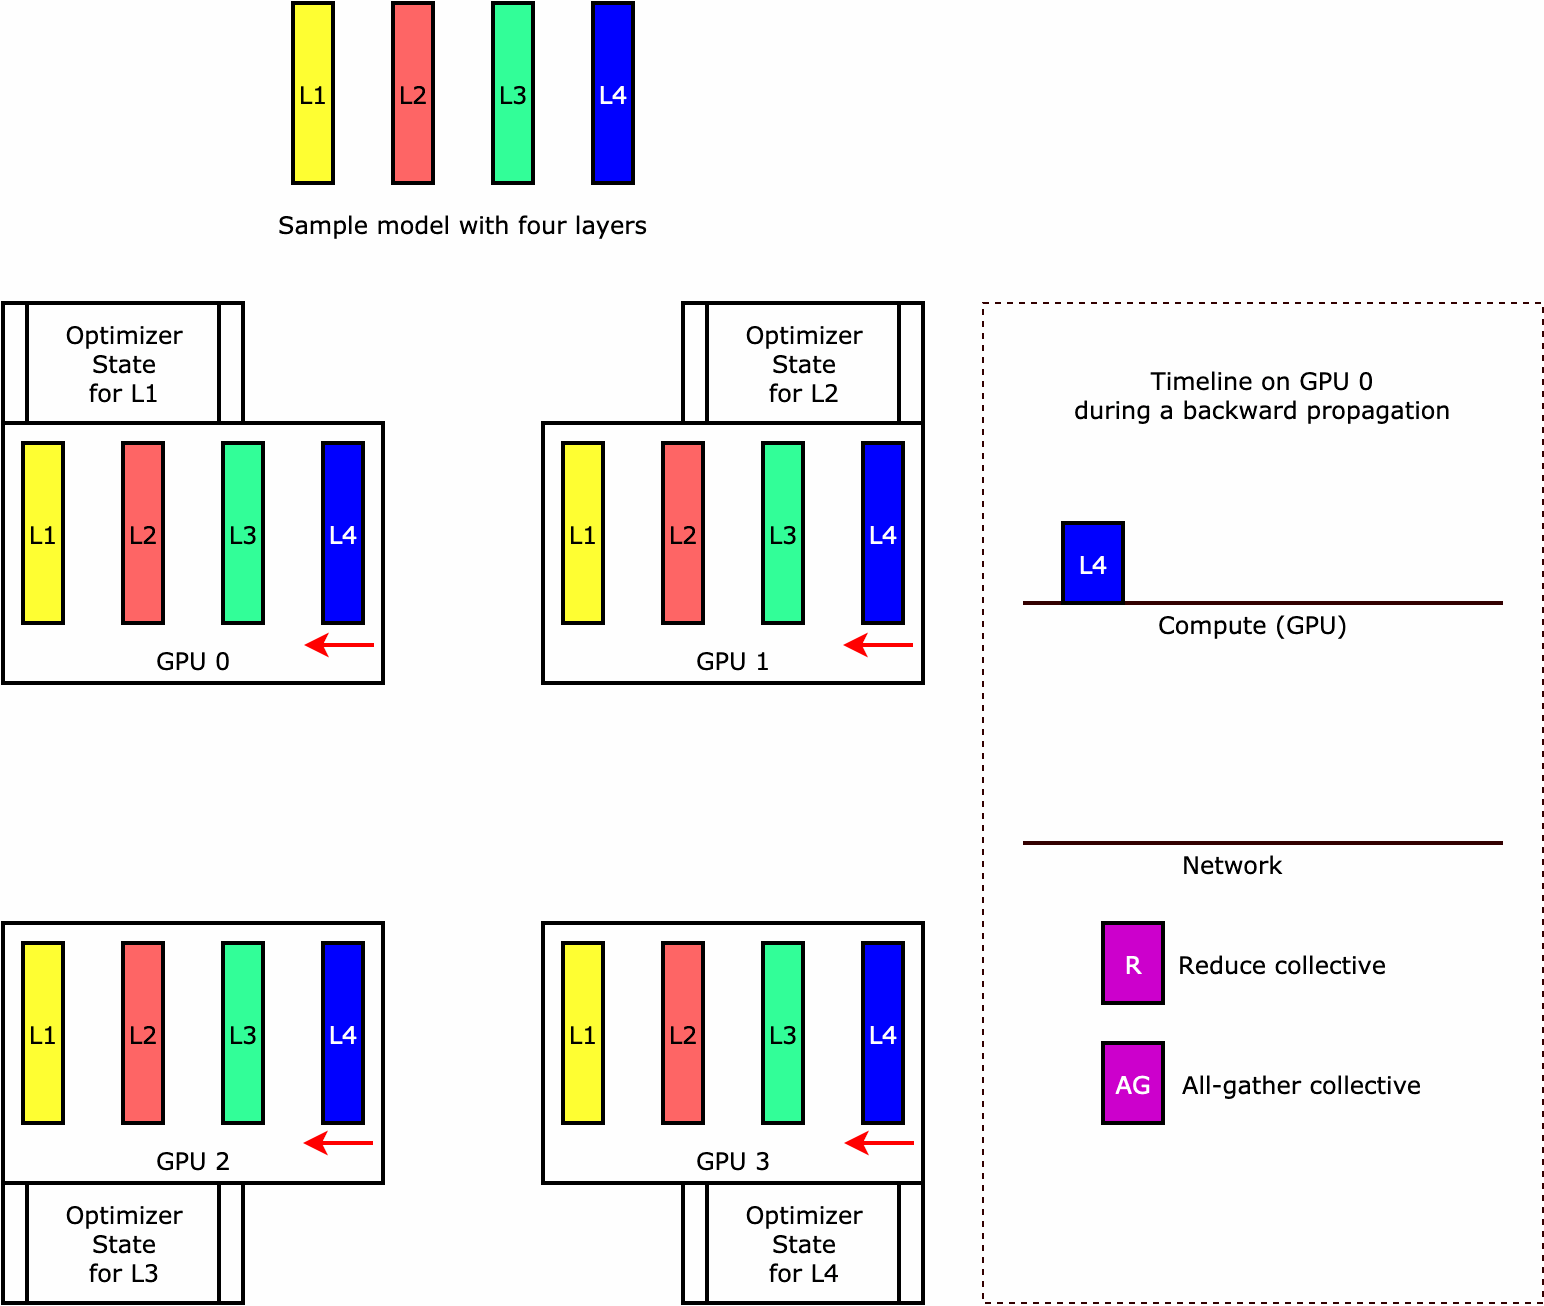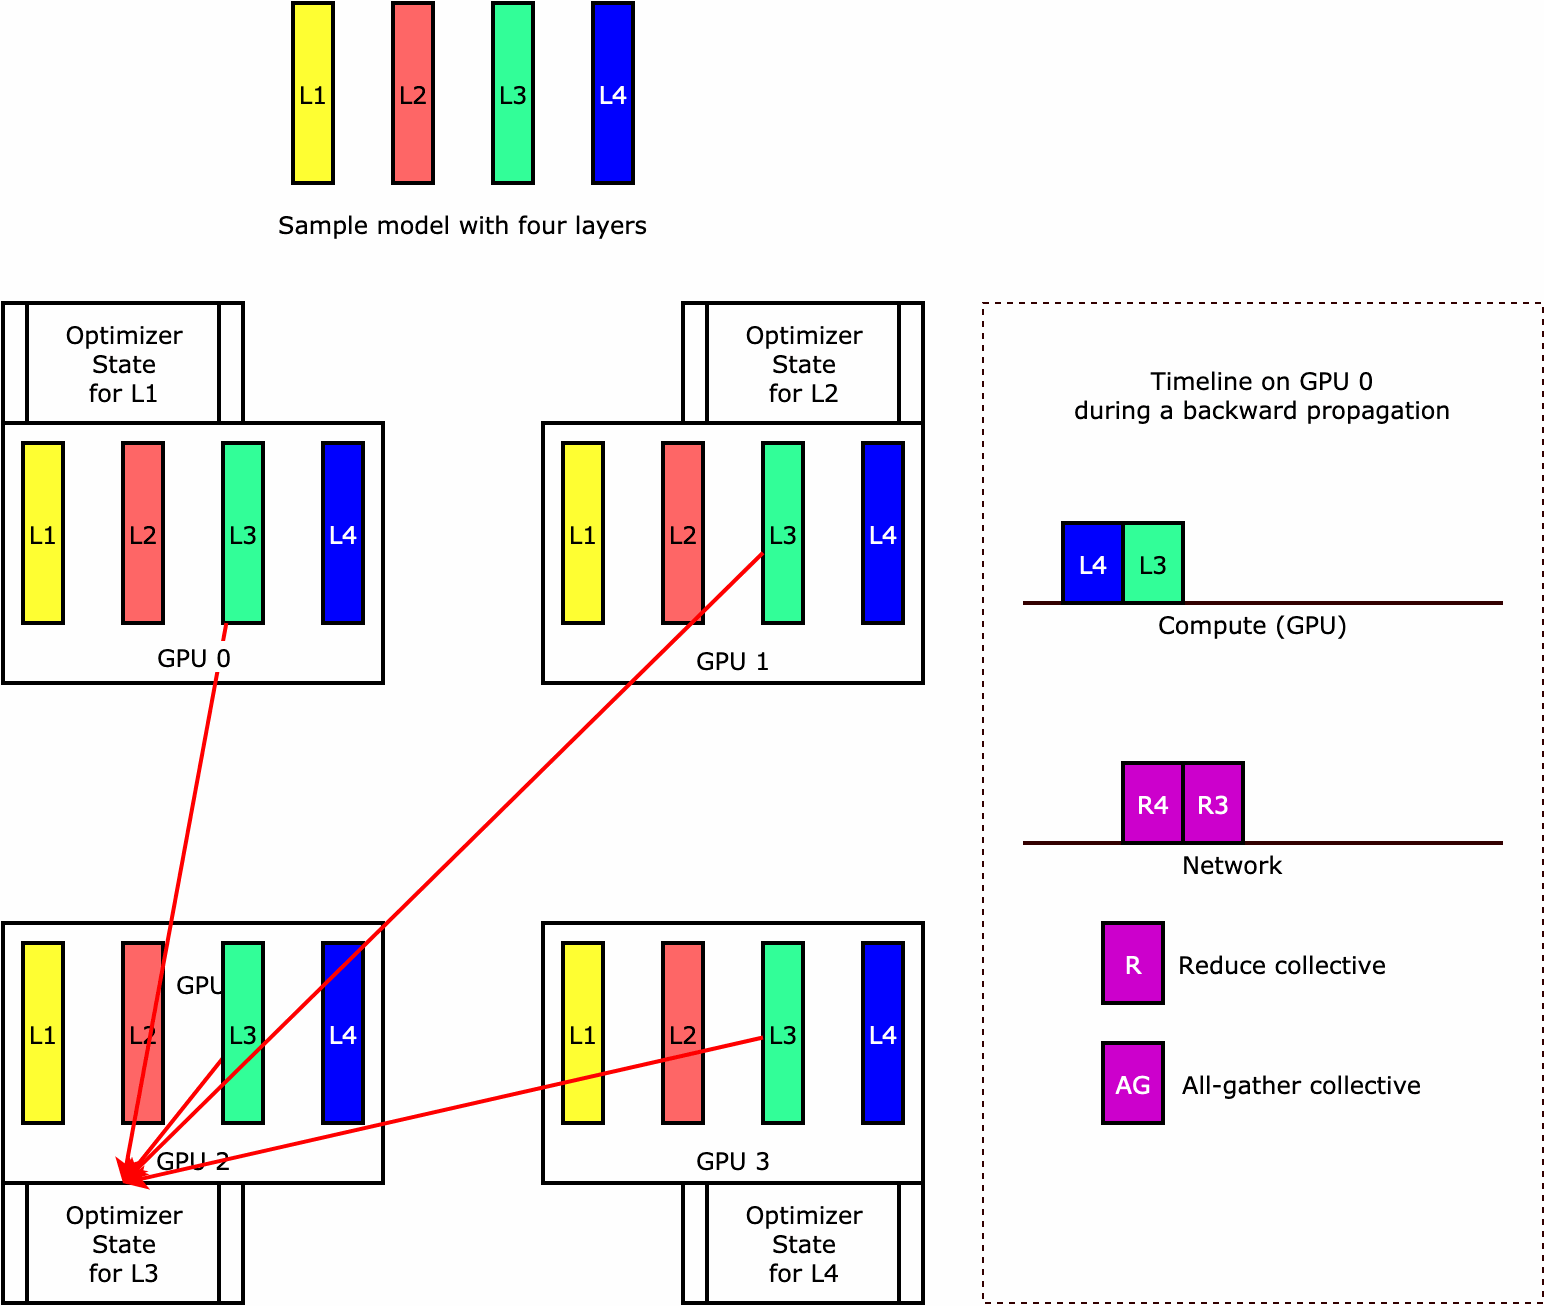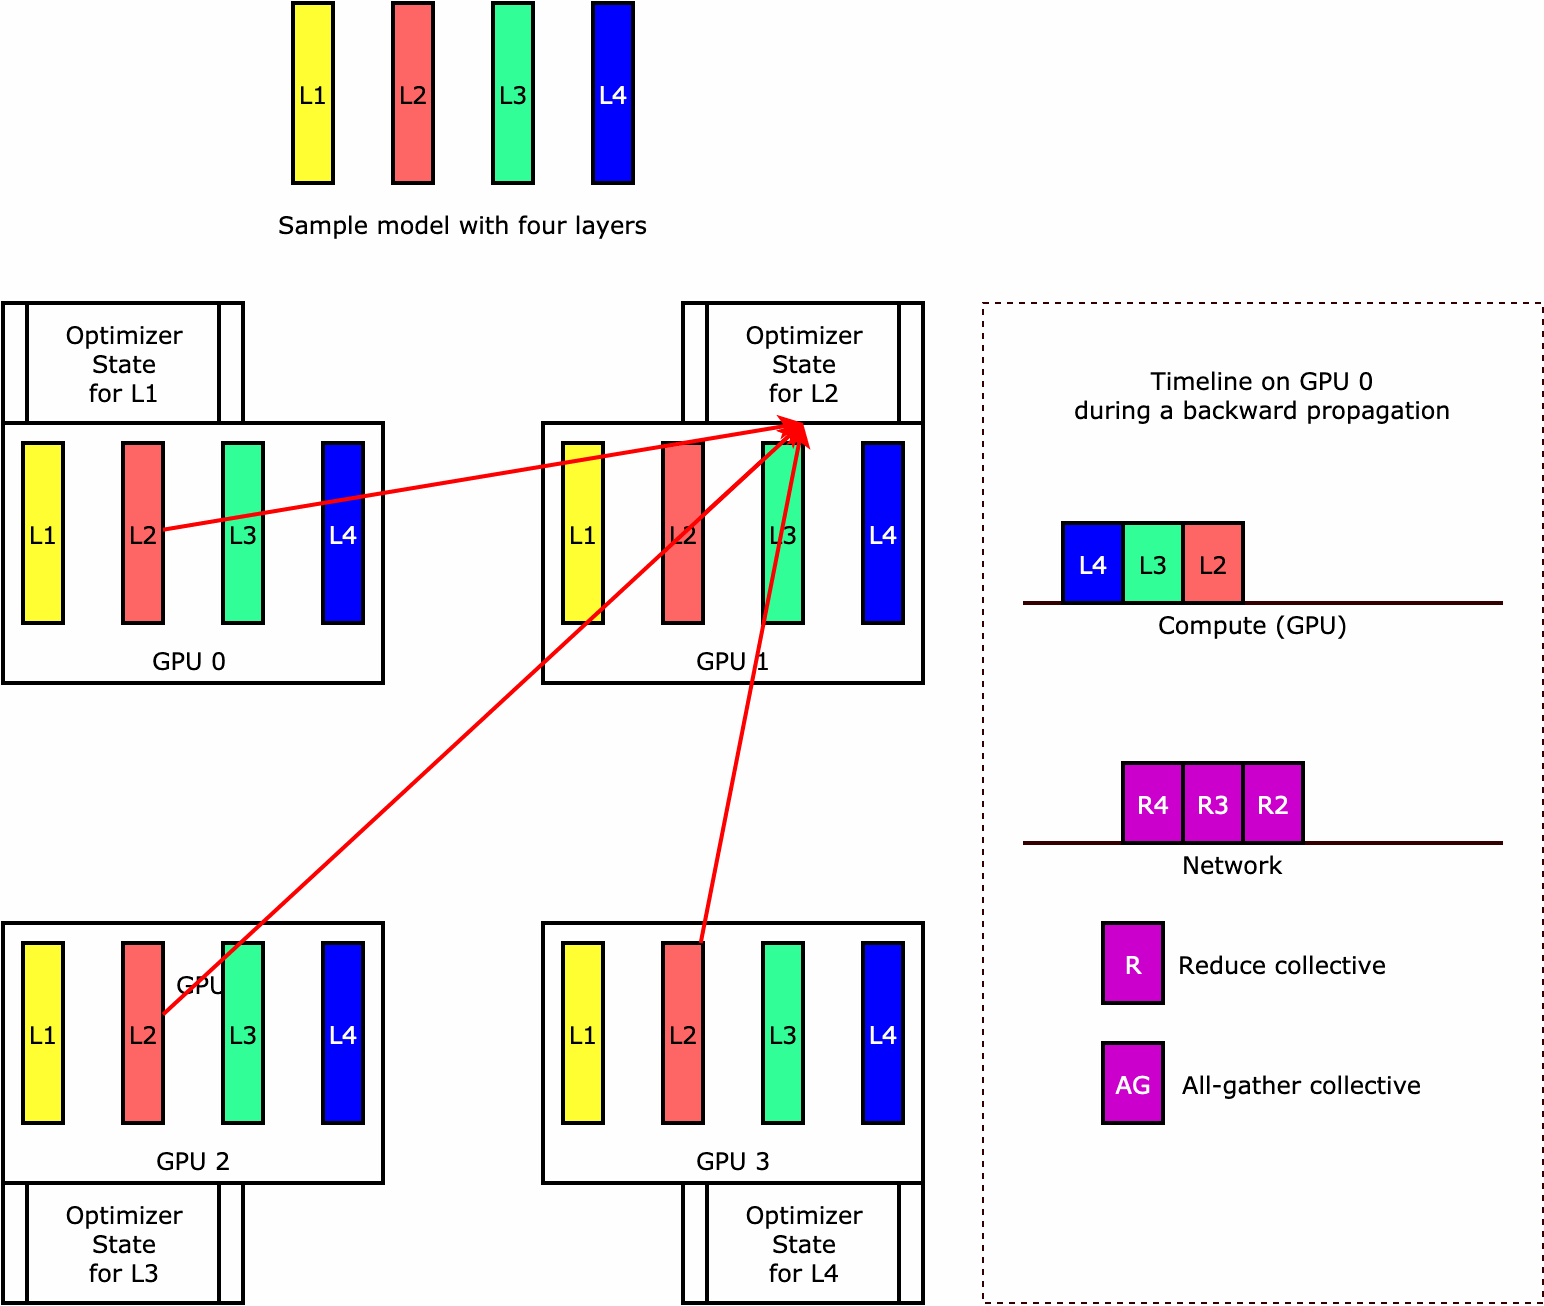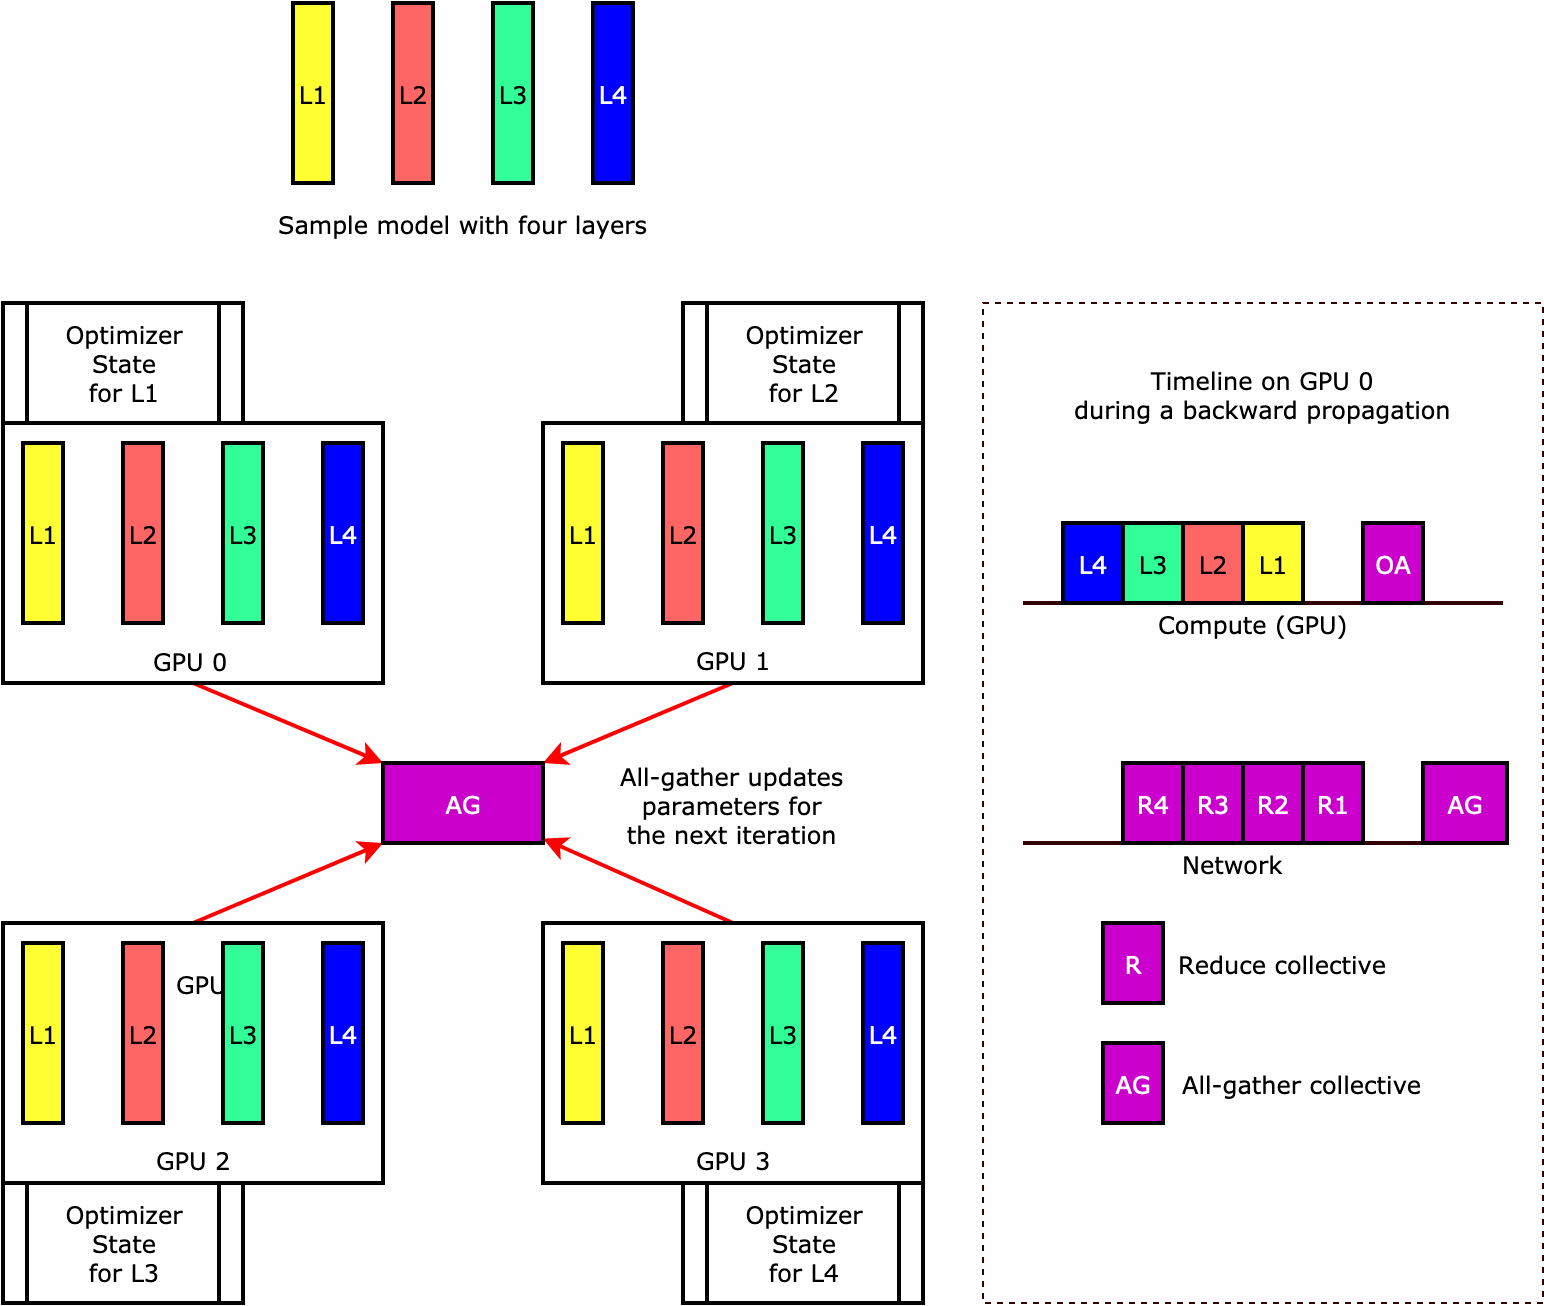
a single replica of the optimizer state is sharded across data-parallel ranks, with no redundancy across devices
ZeRO-1
- 前向与反向传播 (Compute): 所有 4 张 GPU 拿着不同的数据(Batch),各自算出了完整的模型梯度(Gradients)。
- Reduce (规约集合通信): 因为 GPU 0 只负责保管 L1 的优化器状态,所以其他三张卡(GPU 1, 2, 3)会把它们算出来的 L1 层的梯度全部通过网络发送给 GPU 0(求和取平均)。同理,GPU 0 也会把自己算出的 L2 梯度发给 GPU 1。
- 参数更新 (Update): 现在,GPU 0 凑齐了 L1 的完整梯度,它掏出自己专属保管的 L1 优化器状态,计算出 L1 层的最新权重。
- All-gather (全收集通信): 最后,GPU 0 把更新好的 L1 最新权重广播发给所有其他卡。大家拼装一下,所有卡又都拥有了最新且完整的模型权重,准备进入下一个 Batch。
Parameter server (PS) based Synchronization 参数服务器同步
Parameter Server (PS) 架构 是早期深度学习(特别是像 TensorFlow 1.x 时代)最主流的同步方案,中心化的模式。 每个学习器/工作节点都会执行完整的模型前向和反向传播,在处理完每个 mini-batch 后,学习器计算出梯度,并将它发送给参数服务器,参数服务器计算出权重的最新值,并将它们发送回各个模型副本。
Straggler problem / 木桶效应
架构缺点是参数服务器 PS 需要等待所有学习器/节点传回更新的梯度后,才能计算并统一更新模型参数。差异来自于学习器底层计算时间的随机波动以及网络通信延迟的随机波动,训练速度永远受制于最慢的那张卡。
Synchronous SGD Variants
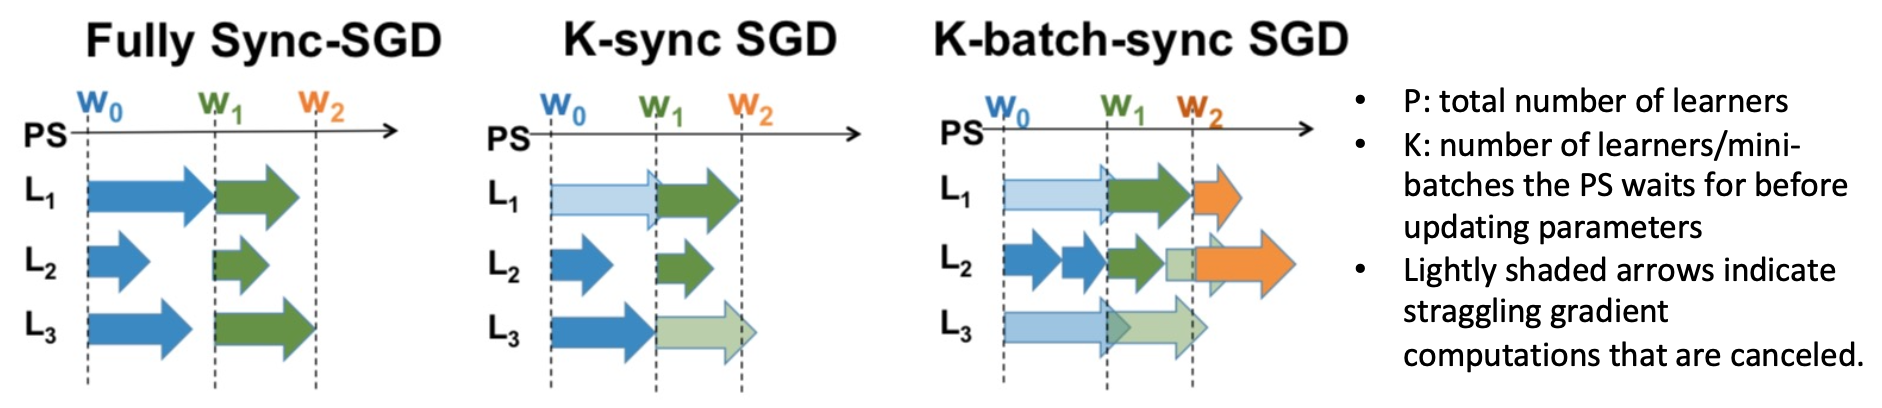 如图,为了解决 Straggler problem,演化出了不同的梯度下降策略,其中:
- P: 学习器/节点 (Learners) 的总数
- K: 参数服务器 (PS) 在更新参数前需要等待的学习器或 mini-batch 的数量
Fully Sync-SGD (完全同步): 必须集齐所有 个节点的梯度才更新。最慢,但绝对准确。
K-sync SGD (K-同步): PS 只等待跑得最快的 个节点传回梯度,一旦凑齐 个,立马更新参数。剩下跑得慢的节点(落后者)的本次计算结果会被直接丢弃(Canceled)。 注:当 时,它就退化成了完全同步。
K-batch-sync SGD (K-批次同步): PS 只看“批次数量”不看 learner。 只要收到 个 mini-batch 的梯度就更新参数,不管这些梯度是来自于哪些节点。跑得快的节点可以连续提交多个 batch 的梯度。每次更新后,所有节点都会去 PS 拉取最新参数,未完成的旧计算会被取消。 优势:相比 K-sync 进一步减少了单次迭代的等待时间,且误差收敛表现一致。
Asynchronous SGD
既然同步机制总要等待,能不能干脆完全不等待?这就是异步 SGD (Async-SGD):任何一个节点只要算完了梯度,随时提交给 PS,PS 立马用它来更新全局权重。
这带来一个致命缺陷:陈旧梯度 (Stale Gradients),即节点用来计算梯度的权重,可能是 PS 上很久以前的旧版本。
当节点算完把梯度交回给 PS 时,PS 上的全局权重可能早就被其他跑得快的节点更新过好几轮了。使用这种“过期/陈旧”的梯度强行更新全局模型,会导致训练极度不稳定、收敛变慢,甚至收敛到一个非常差的局部最优解。
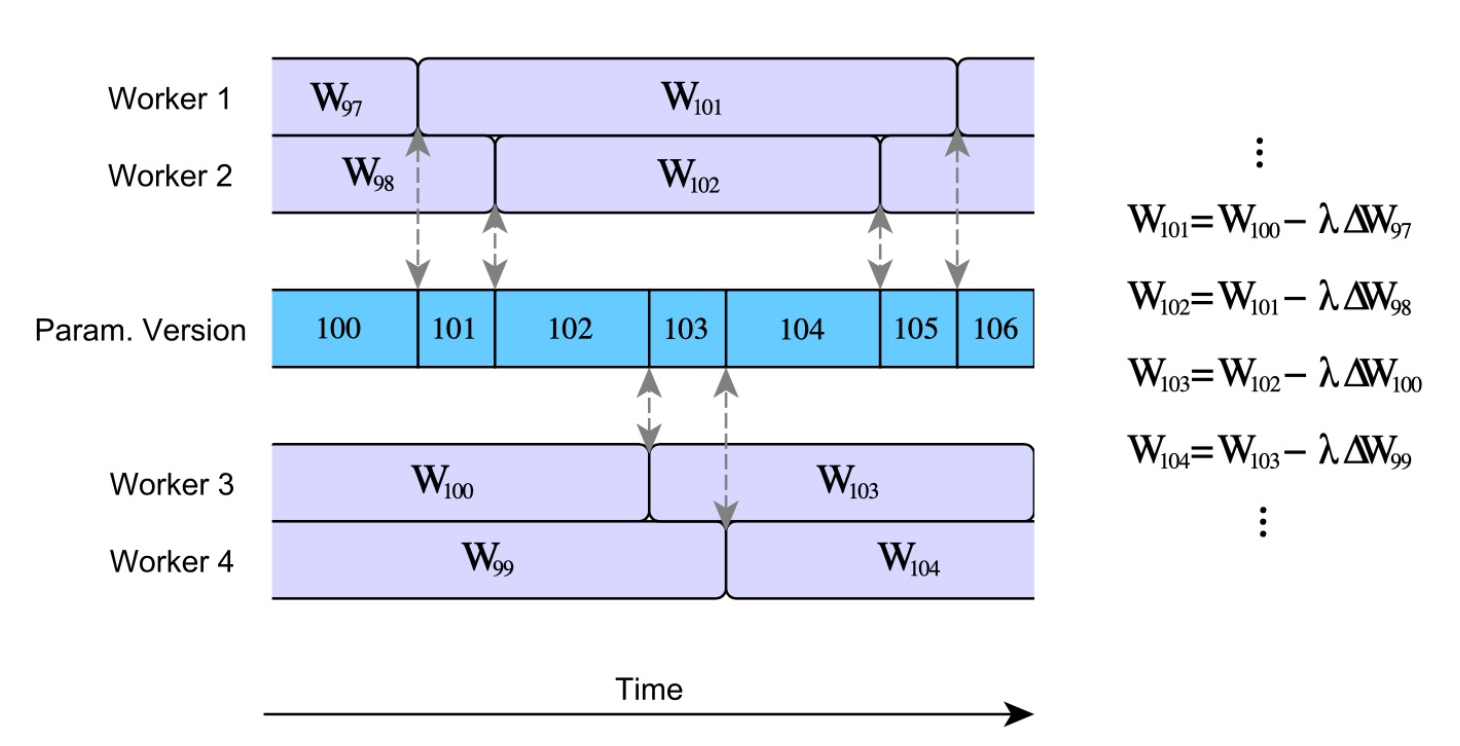
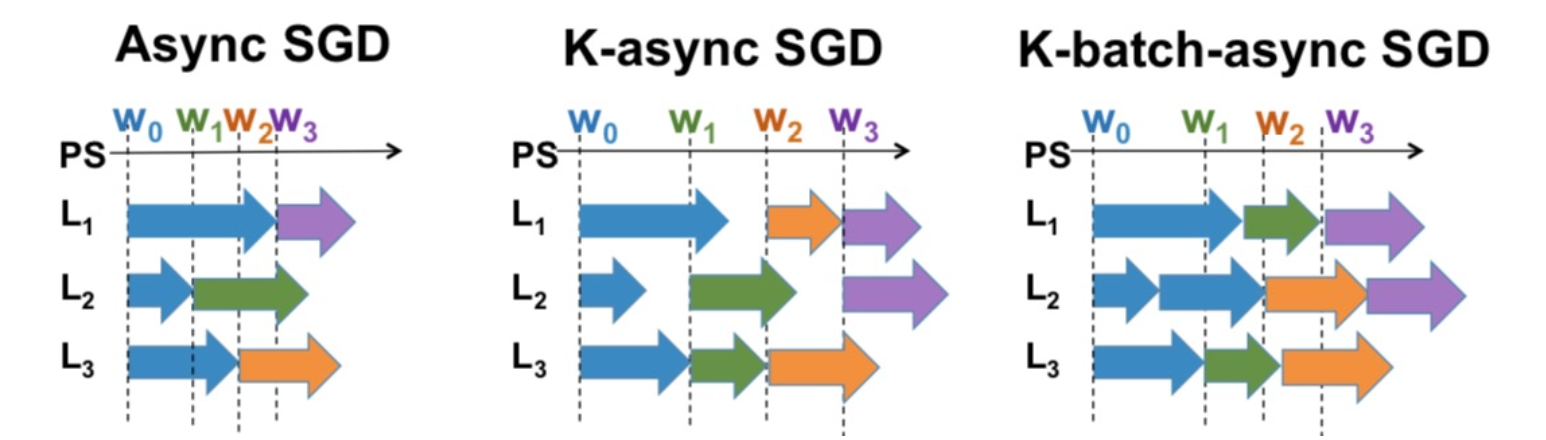
Async SGD (标准异步 SGD) 参数服务器(PS)在收到任何一个学习器(Learner)的梯度后,立即进行全局参数更新,无需等待其他学习器。 系统处于无锁(Lock-free)或细粒度锁状态,各节点完全独立并行。 由于缺乏同步屏障,学习器极易基于旧版本的参数(Stale parameters)计算梯度,这从根本上破坏了标准 SGD 的数学收敛保证,引入了极大的更新噪声。
K-async SGD (K-异步) PS 设定了一个阈值,只有在收集到来自 个不同的学习器的梯度后,才执行一次参数更新。 当参数 时,该策略在数学与执行逻辑上完全等价于上述的 Async SGD。 与同步版本(K-sync)会直接取消未完成节点不同,K-async 不会取消(not canceled) 剩余的落后节点。这意味着每个学习器最终都会提交作业,导致必然有部分学习器提交基于陈旧参数版本计算出的无效或有害梯度。
K-batch-async SGD (K-批次异步) 进一步放宽了更新条件。PS 仅统计接收到的 个 mini-batches 的梯度来触发更新,而不再区分这些梯度具体来自哪个学习器。 无论哪个学习器率先完成计算,它都会将梯度推送到 PS,随即从 PS 抓取最新的参数,并立即基于该最新参数开始下一个 mini-batch 的梯度计算。同样,系统不会取消未完成的落后者。 这种机制进一步减少了单次迭代的运行时间(Runtime per iteration),同时在误差收敛(Error convergence)特性上与 K-async 保持一致。
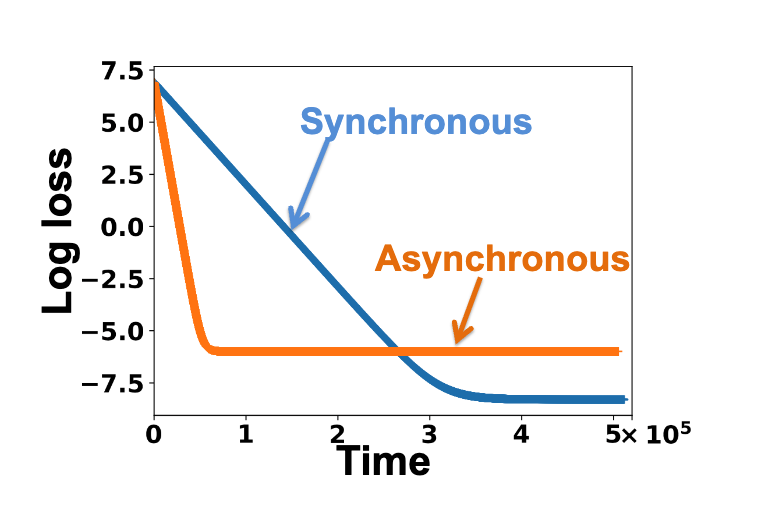
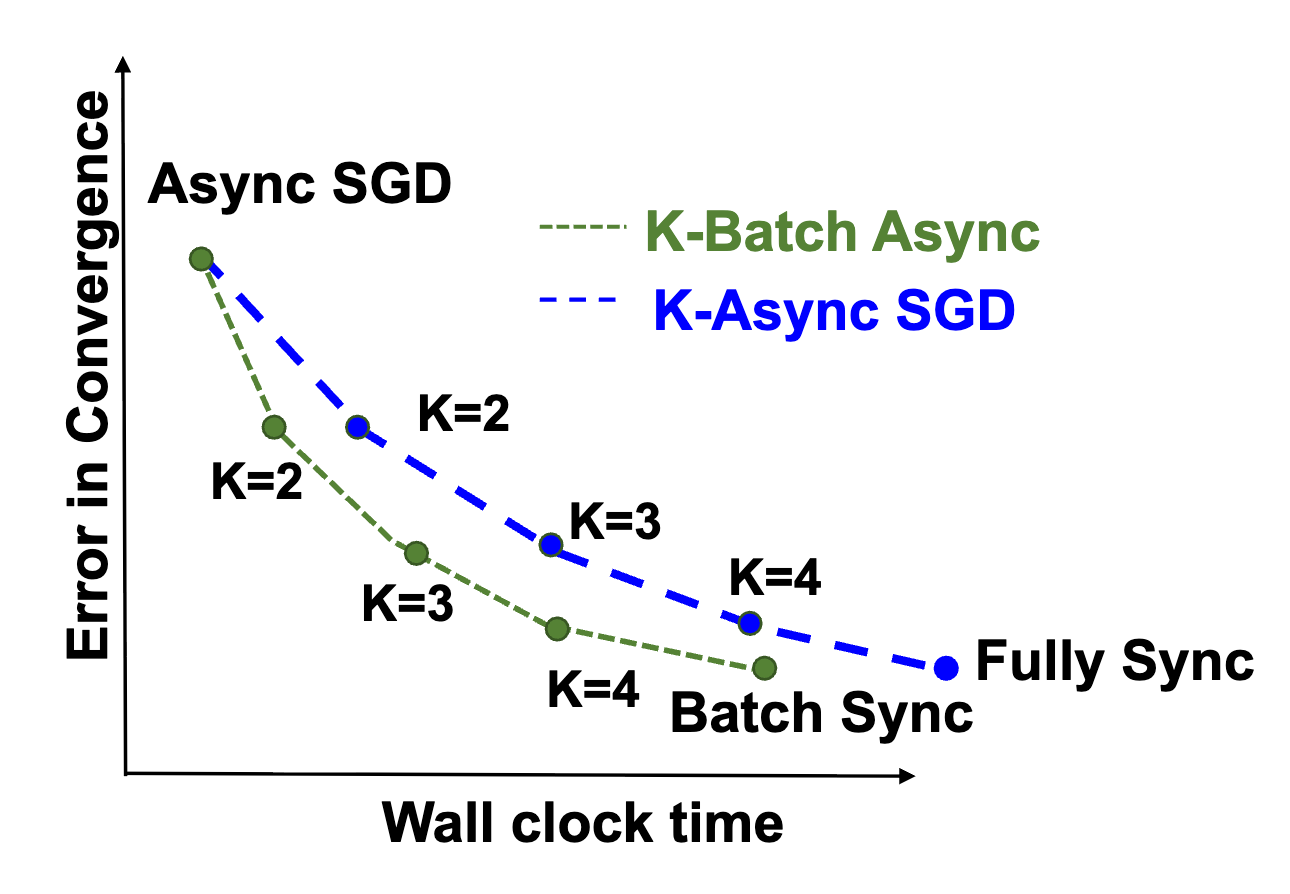
Slow and Stale Gradients Can Win the Race: Error-Runtime Trade-offs in Distributed SGD
- Error-runtime trade-off for Sync and Async-SGD with same learning rate.
- Async-SGD has faster decay with time but a higher error floor. (Stale parameters)
Ring All-Reduce
先分摊计算,再广播结果
在现代多卡集群中,同步操作脱离了中心化的 Parameter Server,通过 Ring All-Reduce (环形全规约) 算法被分担到不同节点上
对于中心化拓扑,GPU 0 的网卡和带宽承受了极大的压力。如果有 个节点,中心节点在同一时刻需要接收 份庞大的模型数据。系统规模越大,中心节点的网络拥堵就越严重。 通过环形拓扑,通信规则被极度简化和去中心化。每个节点拥有一个左邻居和一个右邻居。每个节点只向其右邻居发送数据,并且只从其左邻居接收数据。网络流量被完美且均匀地平摊到了环上的每一条连接线中。系统消除了单点拥堵,使得集群通信带宽的利用率达到了理论上的最大值。
Scatter-Reduce
GPUs exchange data such that every GPU ends up with a chunk of the final result
GPU 之间在环形拓扑上不断交换数据块并进行局部求和。当这个阶段结束时,没有任何一张 GPU 拥有完整的结果,但是每一张 GPU 都持有了最终结果的其中一个完整数据块。
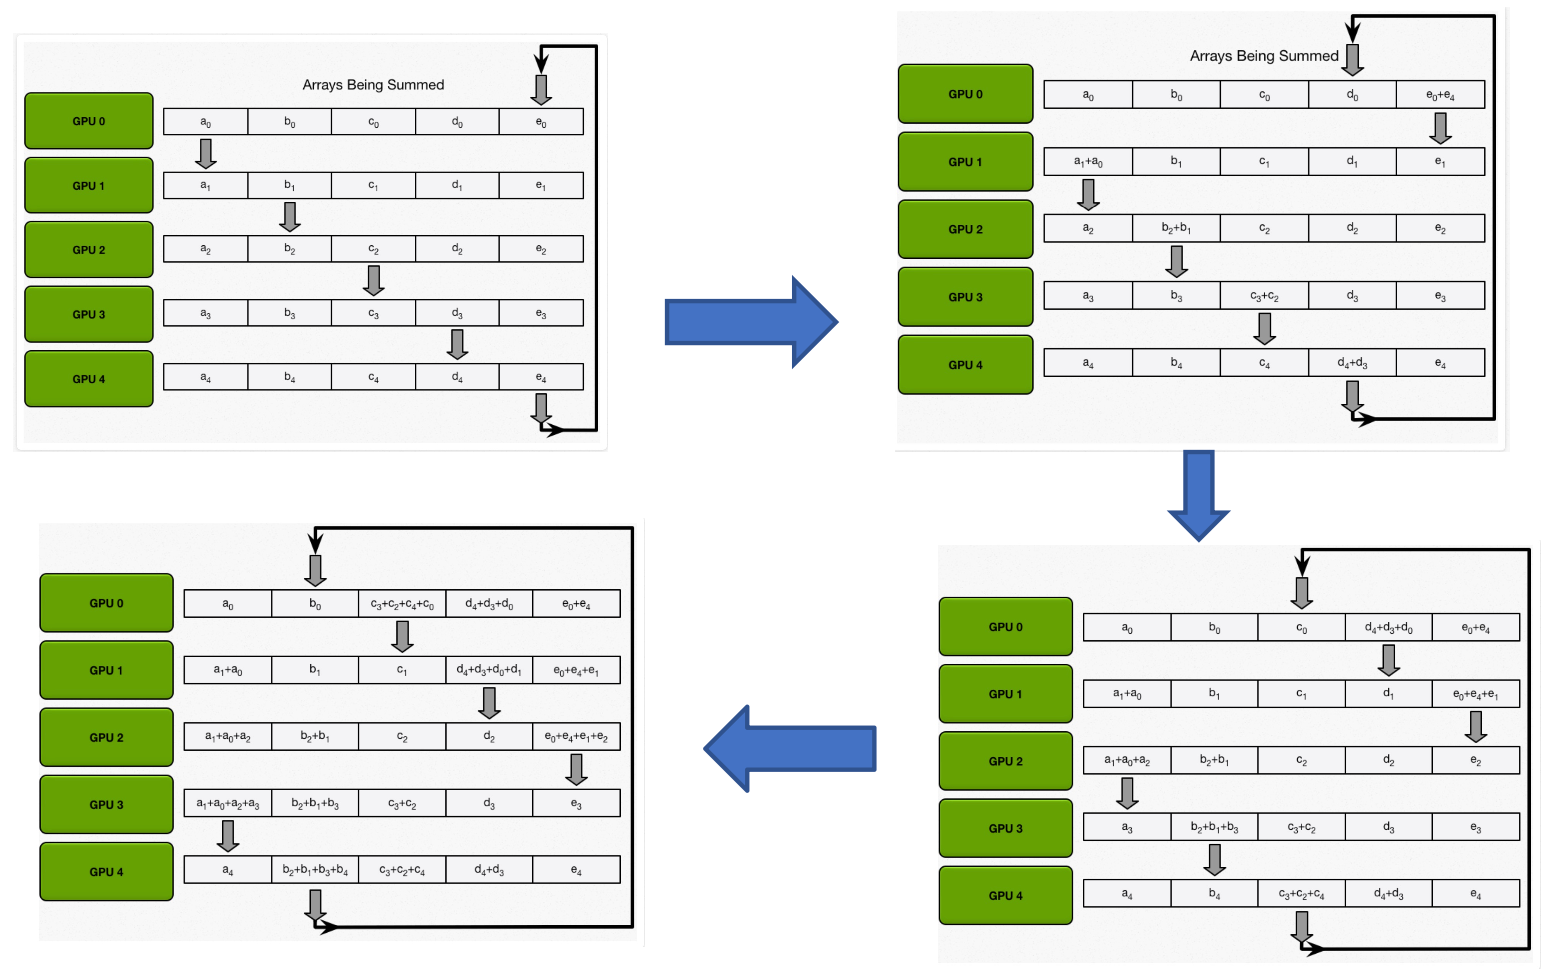
All-Gather
GPUs exchange chunks from scatter-reduce such that all GPUs end up with the complete final result.
在环上把各自算好的最终数据块(chunks from scatter-reduce)传递一圈。所有 GPU 收集齐了别人发来的结果块,最终拼凑出完整的、全员一致的全局梯度数组。
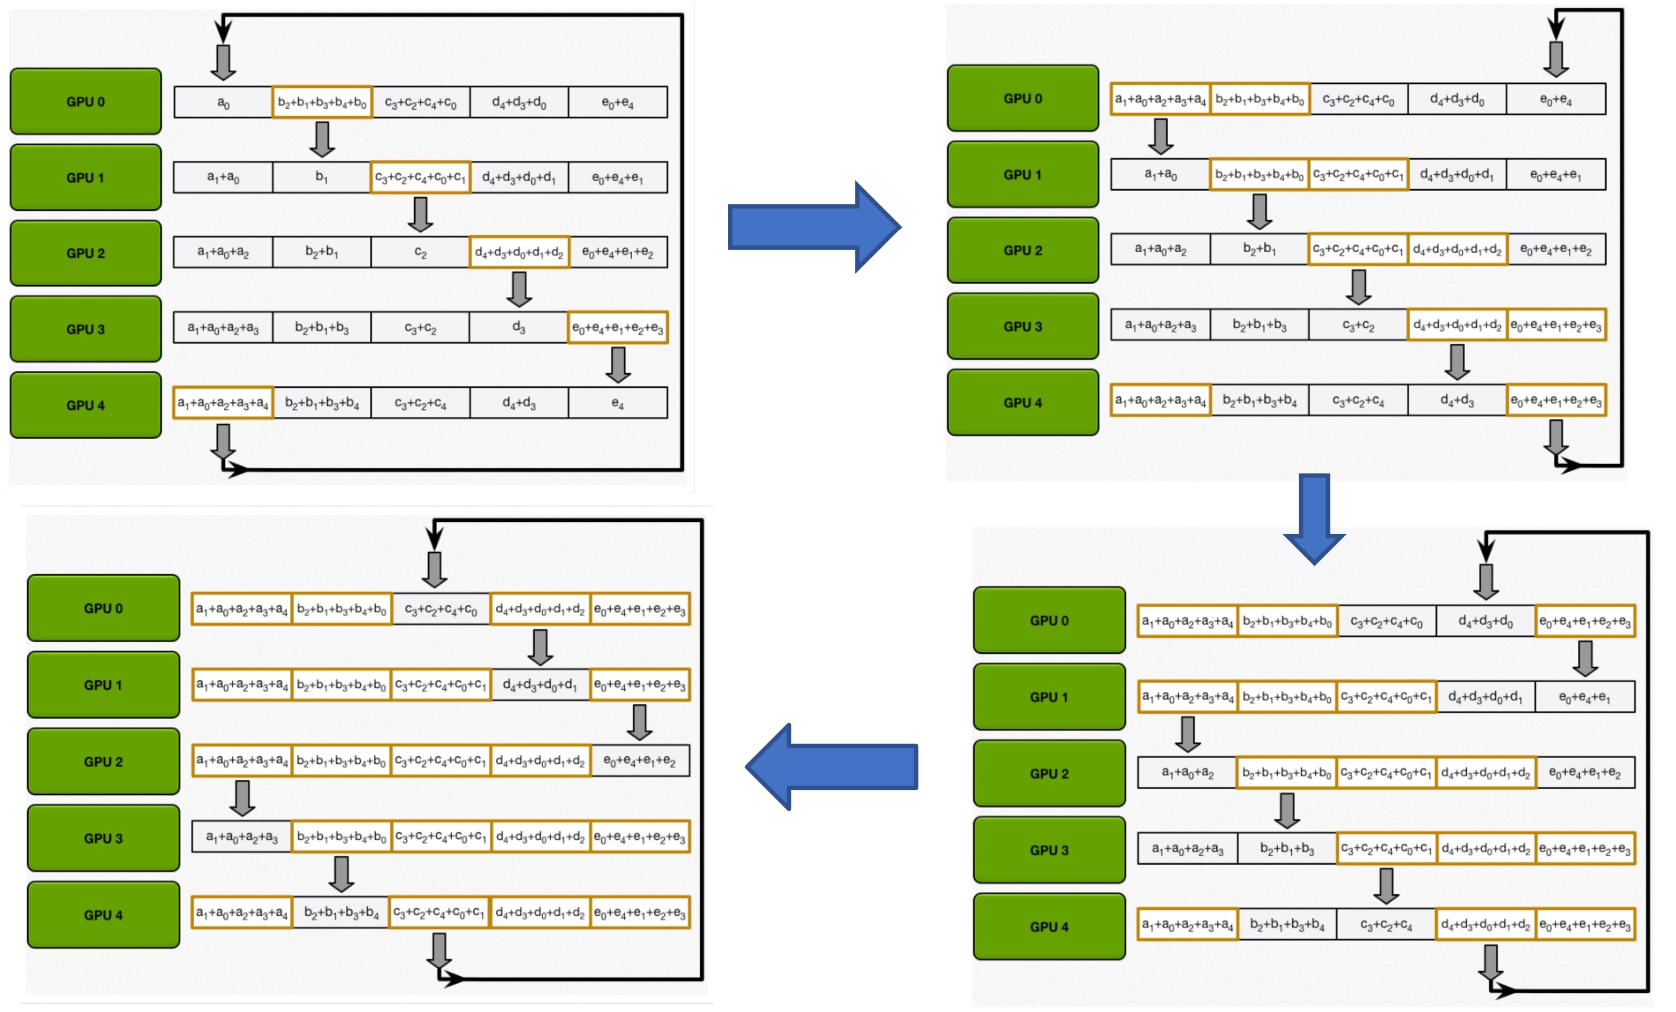
下面通过复杂度推导,给出为何现代大模型训练必须采用 Ring All-Reduce 的证明:
P: number of processes N: total number of model parameters
PS (centralized reduce):
- Amount of data sent to PS by (P-1) learner processes: N(P-1)
- After reduce, PS sends back updated parameters to each learner
- Amount of data sent by PS to learners: N(P-1)
- Total communication cost at PS process is proportional to 2N(P-1)
Ring All-Reduce (decentralized reduce):
- Scatter-reduce: Each process sends N/P amount of data to (P-1) learners
- Total amount sent (per process): N(P-1)/P
- AllGather: Each process again sends N/P amount of data to (P-1) learners
- Total communication cost per process is 2N(P-1)/P
PS communication cost is proportional to P whereas ring all-reduce cost is practically independent of P for large P (ratio (P-1)/P tends to 1 for large P) 对于 Ring All-Reduce 而言,当集群规模 变得非常大时,系数 在数学上极其趋近于1。无论用多少张卡训练,Ring All-Reduce 中每张卡的单次同步通信量都被限制在大约 左右,在物理层面上实现了与进程数 无关的高扩展性。
Note: 尽管拓扑结构完全不同,但这两种方案在算法语义上都属于同步参数更新(synchronous parameter updates)
Distributed Training Frameworks
训练数据规模,单步计算量和计算速率基本决定了训练耗时,其中的可变因素是计算速率,也是我们优化的目标。 • 深度学习训练耗时:
计算速率又由三个因素决定:单设备计算速率,设备数,以及多设备并行效率。 • 计算速率:
为此,在现有的AI框架(如PyTorch、TensorFlow、Caffe、JAX、MindSpore ...)之上,我们还需要一层大模型的使能层,特别是大模型的训练和推理框架。常见的分布式训练框架有 DeepSpeed、Megatron-LM、Colossal-AI 以及 HuggingFace 的 Accelerate 库。
分布式训练的核心功能:
- 部署和训练以Transformer为核心的大模型
- 提供数据/模型/流水并行 - 多维并行
- 以集合通信和参数服务器(Parameter Server)方式进行资源整合
首先来看 DeepSpeed,这是由微软开源的一个深度学习优化库,旨在提高大模型训练效率和扩展性。DeepSpeed 主要使用了数据并行(Data Parallelism, 通过 ZeRO)、模型并行(PP)、梯度累积、动态缩放、混合精度等训练加速手段。此外,该框架还支持分布式训练管理,内存优化和模型压缩等,协助管理和优化大模型训练任务。
再看 Megatron-LM ,这是 NVIDIA 开发的一个深度学习框架,专门用于大模型的分布式训练。它通过极致的算子融合,以及 3D 并行 —— 数据并行、张量并行(Tensor Parallelism)和流水线并行(Pipeline Parallelism)的组合,将单卡的计算效率(MFU/TFLOPs)推向极限。Megatron-LM 提供了强大的tokenizer以及数据预处理与管理工具。
DeepSpeed更多被用于中等规模集群(数十到数百卡)预训练以及下游任务微调环节,超大规模集群(千卡、万卡级)更多采用 NVIDIA 的 Megatron-LM,并随后取长补短,发展为 Megatron-DeepSpeed,既保证了超大规模下的并行效率,又利用了 ZeRO 来降低显存占用。
值得关注的是,随着分布式技术的进一步发展,格局也在发生细微变化。NVIDIA 通过推出的模块化版本的 Megatron Core,试图拿回被 DeepSpeed 占领的中小规模市场;而 Meta 推出的 PyTorch 原生的 FSDP 也正成为 DeepSpeed 的强力竞争对手,尤其是在追求与原生 PyTorch 兼容的科研场景中。
除此之外,潞晨科技(HPC-AI Tech,由新加坡国立大学校级教授尤洋创建)的 Colossal-AI 框架提供了丰富的张量并行策略与配置案例;由 OpenBMB 开源社区(由清华大学NLP实验室和面壁智能发起)开发的 BMTrain 框架深度优化了DeepSpeed的并行策略,支持北京智源研究院的 Aquila 系列模型;华为也推出了在大模型领域对标 NVIDIA 生态的昇腾(Ascend)原生大模型加速库 MindSpeed。
DeepSpeed
https://github.com/deepspeedai/DeepSpeed
训练方面为大模型提供ZeRO、3D-Parallelism、DeepSpeed-MoE、ZeRO-Infinity等特性。在推理,压缩以及 AI4Science 也有相应功能。
APIs
配置参数在 ds_config.json 中,通过API接口可以调用 DeepSpeed 训练/推理模型
Runtime
Runtime 是指模型执行时的软件环境和调度系统。它负责把训练好的模型文件(如 .onnx 或 .pt)加载起来,并管理硬件资源(GPU/CPU/NPU)来执行计算。它主要负责:
- 资源调度:决定把哪个计算任务分配给哪个 GPU
- 内存管理:vLLM、DeepSpeed这类训推框架,核心价值就在于 Runtime 阶段的显存优化
- 图优化:在不改变模型结果的前提下,把一些计算步骤合并(如算子融合)
- 以及故障检测,CheckPoint 保存和加载
Ops
Ops(Operators 的缩写),即算子,是模型中最小的计算单元,负责优化计算和通信,提供底层操作。大模型本质上是一个由成千上万个 Ops 组成的有向无环图(DAG)。它主要支持:
- 数学运算:每个 Ops 完成一个具体的数学动作,比如矩阵乘法(MatMul)、激活函数(ReLU)、层归一化(LayerNorm)。
- 输入输出:每个 Ops 接收一个或多个 Tensor(张量),处理后输出一个新的 Tensor。 不过,Ops 有时也指 Operations(运维/工程化),如LLMOps,是指大模型从数据准备、训练、部署到监控的整个生命周期管理流程。这属于工程管理范畴,不属于底层计算定义的 Ops,注意结合上下文区分。
显存占用分析
The memory consumption when training a deep learning model can be divided into two parts:
- Model States. For large models, most of the memory consumption is occupied by the model state, which mainly includes three parts: Optimizer States, Gradients, and Parameters. The three parts are abbreviated as OPG.
- Residual States. It includes activation functions, temporary buffers, and unusable memory fragments.
Model States 模型本身相关且必须存储的参数:
- Parameters:模型参数 FP32 (4 Bytes) -(if 混合精度)-> FP16 (2 Bytes)
- Gradients:模型梯度 FP32 (4 Bytes) -(if 混合精度)-> FP16 (2 Bytes)
- Optimizer States:if Adam
- Master weight (fp32): 4 Bytes
- Adam momentum (fp32):4 bytes
- Adam Variance (fp32): 4 bytes
各种并行主要优化的是 model states
Residual States 非模型必须,训练过程中产生的参数:
- Activation:激活值
- Temporary Buffers:临时存储,如算子的中间变量
- Unusable Fragmented Memory:碎片化存储空间 激活值加临时存储约 8 Bytes
分析一下,在全精度训练(FP32 + Adam)的基线下 Parameters 4B + Gradients 4B + Adam Momentum 4B + Adam Variance 4B = 16 B AMP 混合精度训练下, Parameters 2B + Gradients 2B + Master weights 4B + Adam Momentum 4B + Adam Variance 4B = 16 B 在这种理想配置下,看似对 optimizer + parameter 的显存节省有限,实际上activation 是节省显存的关键,同时低精度导致 Tensor Core 吞吐暴涨,提高了 GPU 利用率
ZeRO
ZeRO Zero Redundancy Optimizer,一系列显存优化方法的统称:
- ZeRO-DP(Data Parallel):ZeRO1/2/3
- ZeRO-R(Reduce): Activation Checkpointing、 Memory Defragmentation
- 把显存占用多的部分offload到CPU上,瓶颈在通讯(一般是PCIE)
- ZeRO-Offload: Offload Strategy && Offload Schedule
- ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning
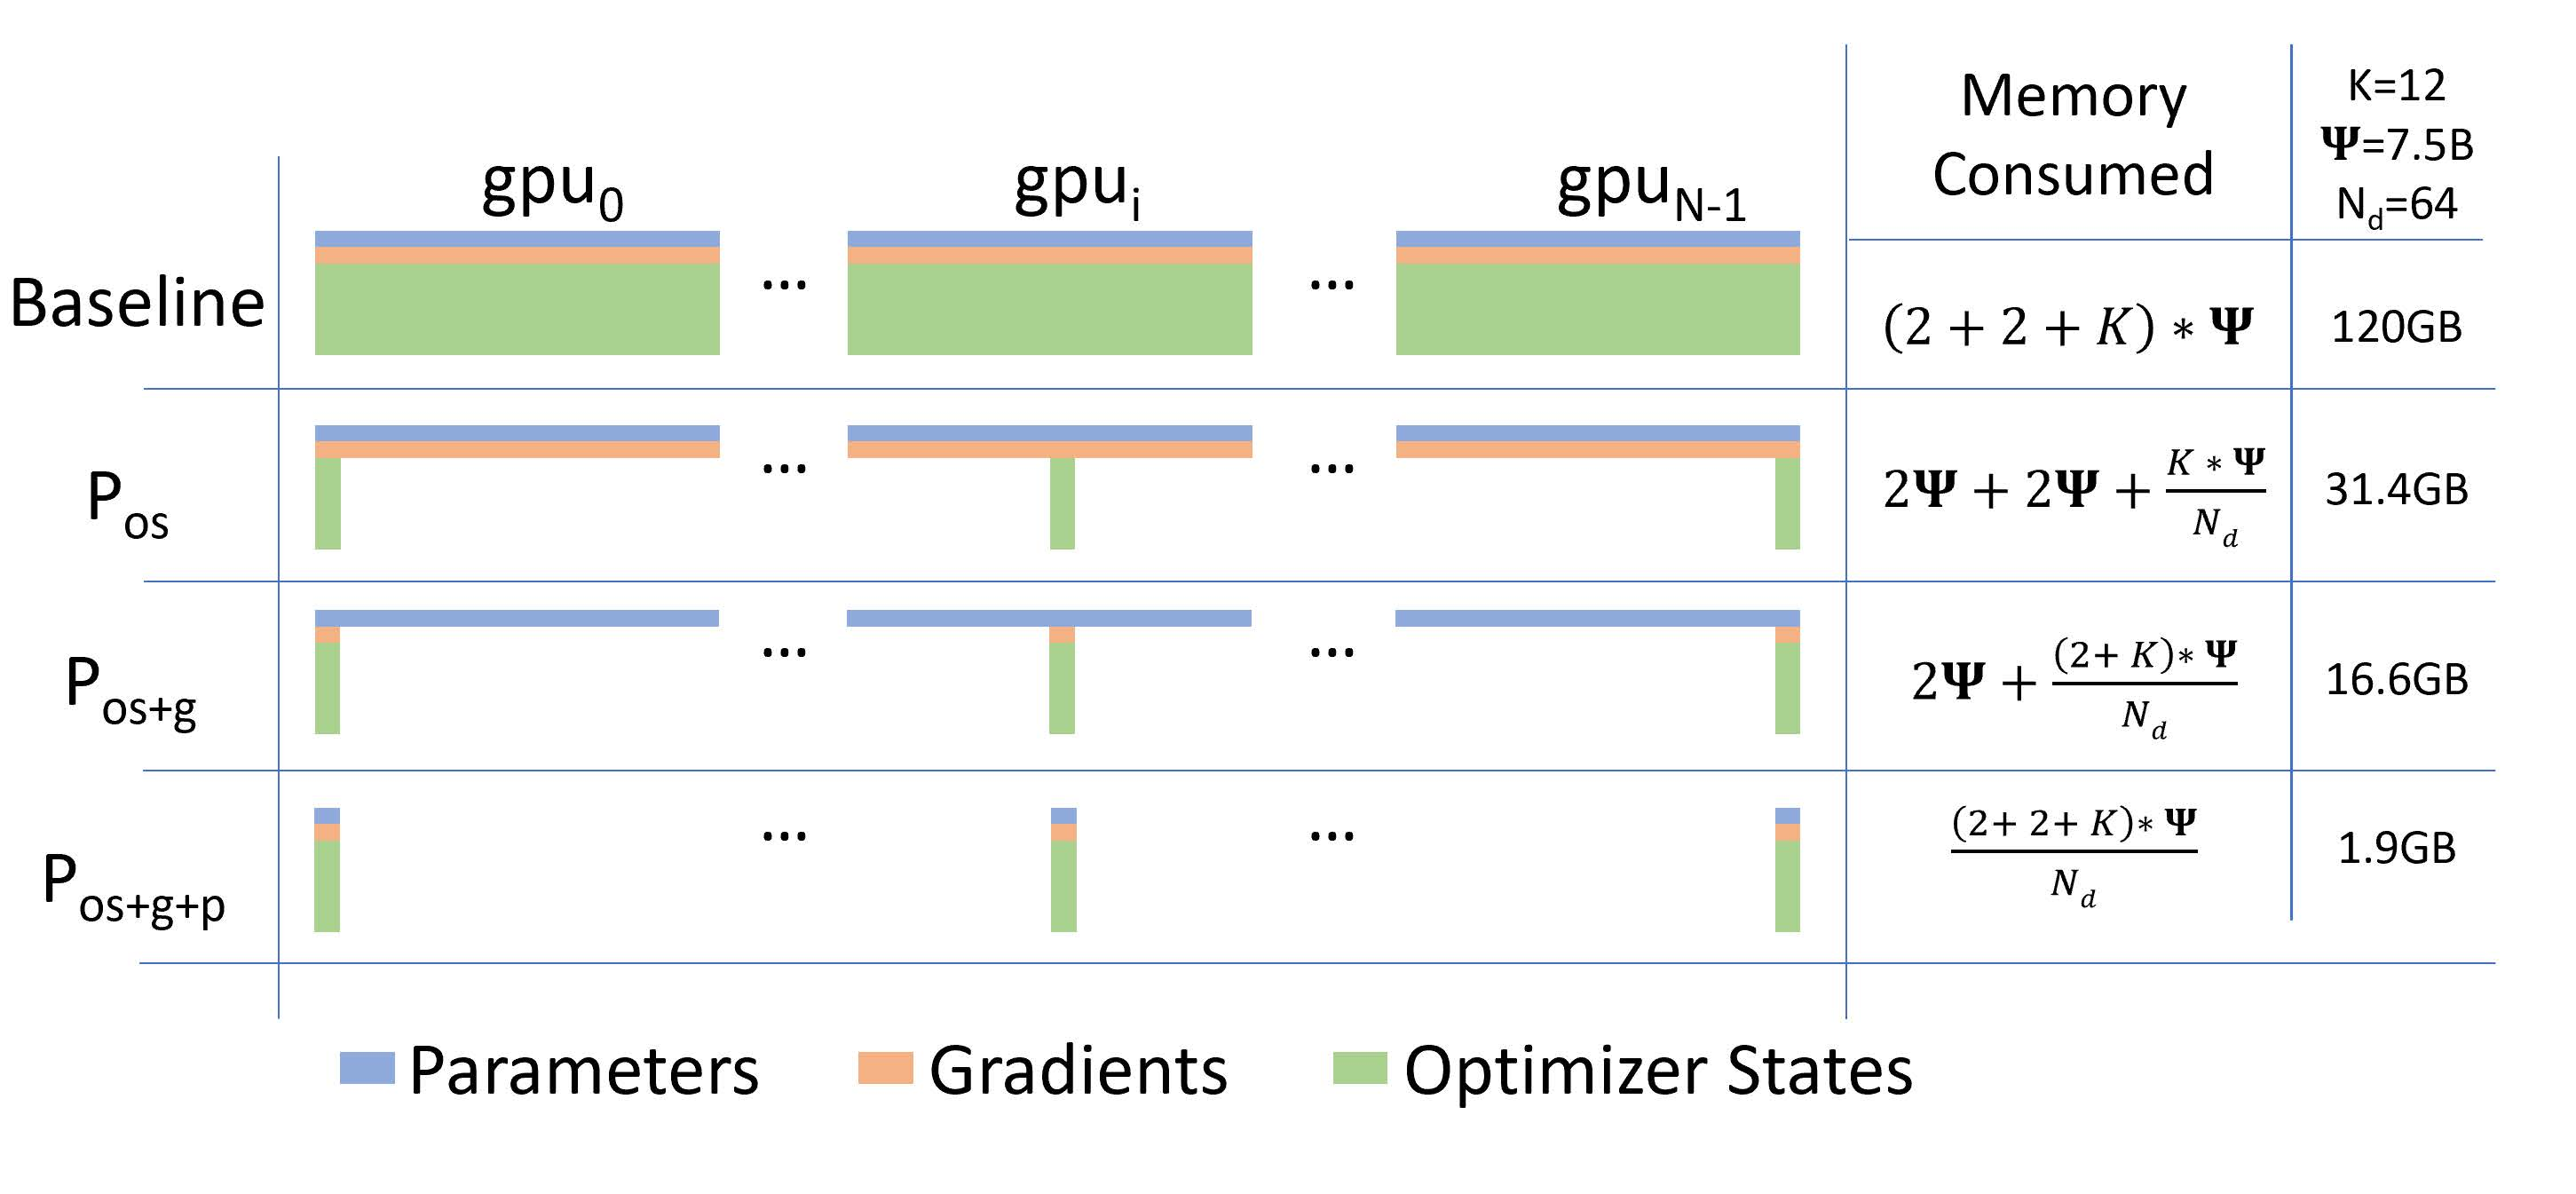
- Optimizer state partitioning(ZeRO stage 1):只对 optimizer 状态进行切分,占用内存原始1/4;
- 把每个GPU计算的完整梯度矩阵直接all-reduce,然后根据每个GPU得到的完整梯度矩阵和部分优化器得到部分的参数矩阵再all-gather每个GPU得到
- Gradient partitioning(ZeRO stage 2):对 optimizer 和 grad 进行切分,占用内存原始1/8;
- Parameter partitioning(ZeRO stage 3):对 optimizer、grad 和模型参数进行切分,内存减少与数据并行度和复杂度成线性关系,同时通信容量是数据并行性的 1.5 倍;
- 通过前向和反向传播中加入all-gather的方式来减少内存占用
DDP
Distributed Data Parallel One full copy of model and training parameters on each GPU 做法: 每一张显卡都拷贝一份完整的模型参数。 通信: 训练时,每张卡处理不同的 Batch。计算完梯度后,调用 All-Reduce 同步所有卡的梯度,然后各自更新参数。 缺点是显存占用极大。如果模型本身有 10GB,你有 8 张卡,那么 80GB 的显存里有 70GB 都在存重复的参数。
FSDP
Motivated by the “ZeRO” paper – zero data overlap between GPUs 做法是把模型参数、梯度、优化器状态全部切碎(Shard),分给所有的显卡。每张卡只存 的模型。 通信:
- 前向传播: 用 All-Gather 临时找回参数,算完立即扔掉。
- 后向传播: 用 Reduce-Scatter 同步梯度,只保留属于自己那份。 理论上FSDP可以训练无限大的模型,只要增加显卡数量即可。
• Helps to reduce overall GPU memory utilization • Supports offloading to CPU if needed • Configure level of sharding via sharding factor FSDP 的核心价值不是更快,而是让大模型“能训练”
Reference:
https://github.com/bitsandbytes-foundation/bitsandbytes https://huggingface.co/docs/transformers/v4.20.1/en/perf_train_gpu_one#anatomy-of-models-memory ZeRO: Memory Optimizations Toward Training Trillion Parameter Models PyTorch FSDP: Experiences on Scaling Fully Sharded Data Parallel https://siboehm.com/articles/22/data-parallel-training 大模型是怎么训起来的?分布式并行框架介绍 #大模型 #分布式并行 #训练 - ZOMI酱