Video Generation
古人的智慧
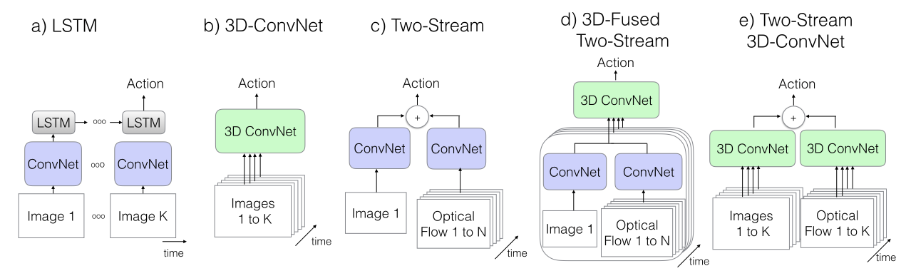
2D Convolution + LSTM
CNN + RNN
3D Convolution
数据/算力需求大 3D CNN 效果一般
Two-Stream Network
- spatial stream: CNN 理解 single frame
- temporal stream: multi-frame optical flow 帧变化的方向 对当前帧以及后续几帧,即只能处理一个clip 效果好
3D-Fused Two Stream
改进双流,处理多clip (叠多个双流 + conv) feature maps -> 3D conv (理解整体视频) -> linear -> result
I3D
https://arxiv.org/abs/1705.07750
Two-Stream + Inflated-3D Network 每一帧都理解 spatial stream -> 3D conv temporal stream -> 3D conv
用训好的2D resnet weight 初始化3D模型 对比曾经3D Convolution 数据/算力变大了
Wan
Wan: Open and Advanced Large-Scale Video Generative Models https://www.bilibili.com/video/BV1wGSKBVEd8 开源sota spatio-temporal VAE
TODO
Meta MovieGen
Tencent Hunyuan
快手 kling
谷歌 Veo 3
OpenAI Sora
字节 Seedance
MiniMax 海螺
阿里 Wan
Mochi