CUDA-LeNet5
从算子细节里,找到性能的空间。
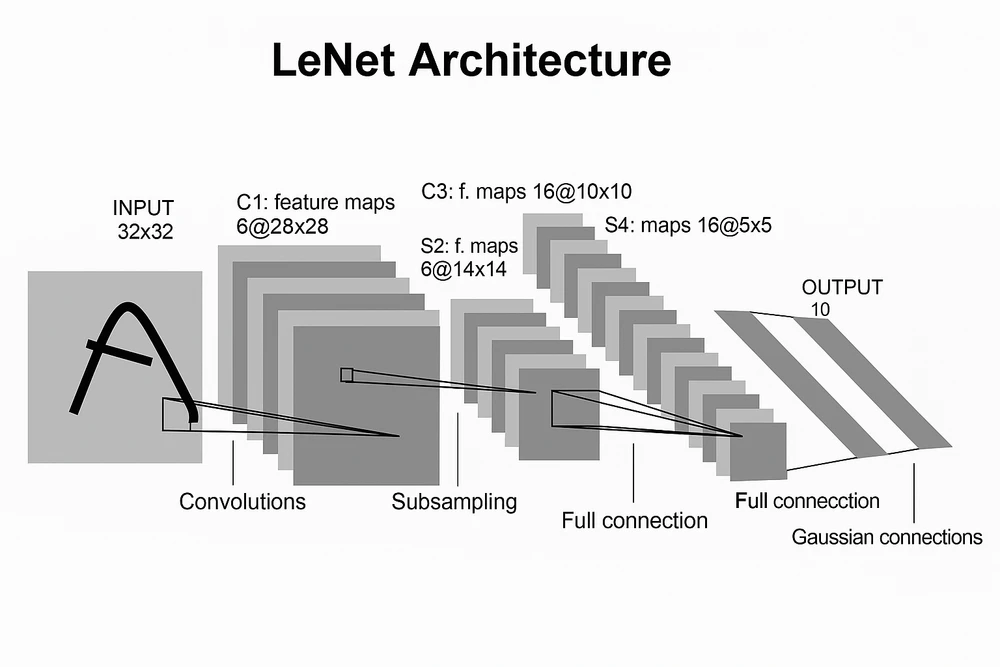
使用 Streams、Tensor Cores、共享内存与量化优化卷积内核;较无优化并行基线提升 36%(项目内测试)。
问题
卷积性能不仅取决于并行线程数。访存方式、数据复用与硬件特性共同决定实际吞吐量。
关键取舍
- Memory & execution
- 使用共享与常量内存分块、Streams、循环展开,减少访存与调度开销。
- Hardware-aware kernels
- 结合 Tensor Cores 与量化探索 GPU 计算能力。
结果
根据项目记录,相较未优化的并行基线提升 36%。结果对应项目内的指定硬件、数据与测试设置。
相关笔记