PACC
看见分布式训练背后的成本。
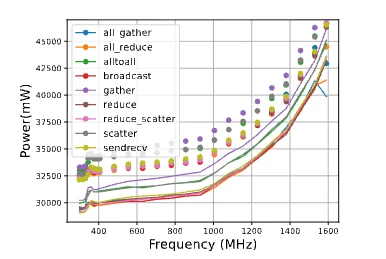
能耗感知的分布式训练通信模拟框架。以真实执行轨迹,连接 GPU 内核、集体通信与系统性能分析。
问题
训练性能无法只通过模型大小判断。通信、内核执行和并行策略共同决定系统的效率。PACC 使用真实工作负载轨迹构建可复用的分析工作流,帮助理解这些成本之间的关系。
关键取舍
- Real execution traces
- 在多 GPU 分布式微调场景中采集执行轨迹,覆盖 FSDP 与 LoRA 工作负载。
- Two levels of visibility
- 同时收集集体通信与内核级执行事件,并完成格式转化,连接模型执行与仿真工具。
- Reusable workflow
- 在四人团队中共同设计端到端仿真流程,支持多个主流模型的能耗与性能分析。
结果
建立了由真实训练与推理轨迹驱动的工作流。我的主要工作是多 GPU 事件采集与格式转换;整体框架为团队协作成果。
相关笔记